日誌記錄
自 v1.2.0 起可用
了解 Harvester 叢集 中正在發生/已經發生的事情非常重要。
Harvester 在叢集啟動後立即收集叢集執行日誌、kubernetes audit(稽核)和 event(事件)日誌,這對於監控、日誌記錄、稽核和故障排除非常有幫助。
Harvester 支援將這些日誌發送到各種類型的日誌伺服器。
日誌資料的大小與叢集規模、工作負載和其他因素有關。Harvester 不使用持久儲存在叢集內部儲存日誌資料。使用者需要相應地設定日誌伺服器來接收日誌。
日誌記錄功能現在透過附加元件實現,在新安裝中預設為停用。
使用者可以在安裝後從 Harvester UI 啟用/停用 rancher-logging 附加元件。
使用者也可以透過自訂 harvester-configuration 檔案,在 Harvester 安裝中啟用/停用 rancher-logging 附加元件。
對於從 v1.1.x 版本升級的 Harvester 叢集,日誌記錄功能會自動轉換為附加元件並保持啟用狀態。
高階架構
Harvester 和 Rancher 都使用 Logging Operator 來管理內部日誌基礎設施的特定元件和操作。
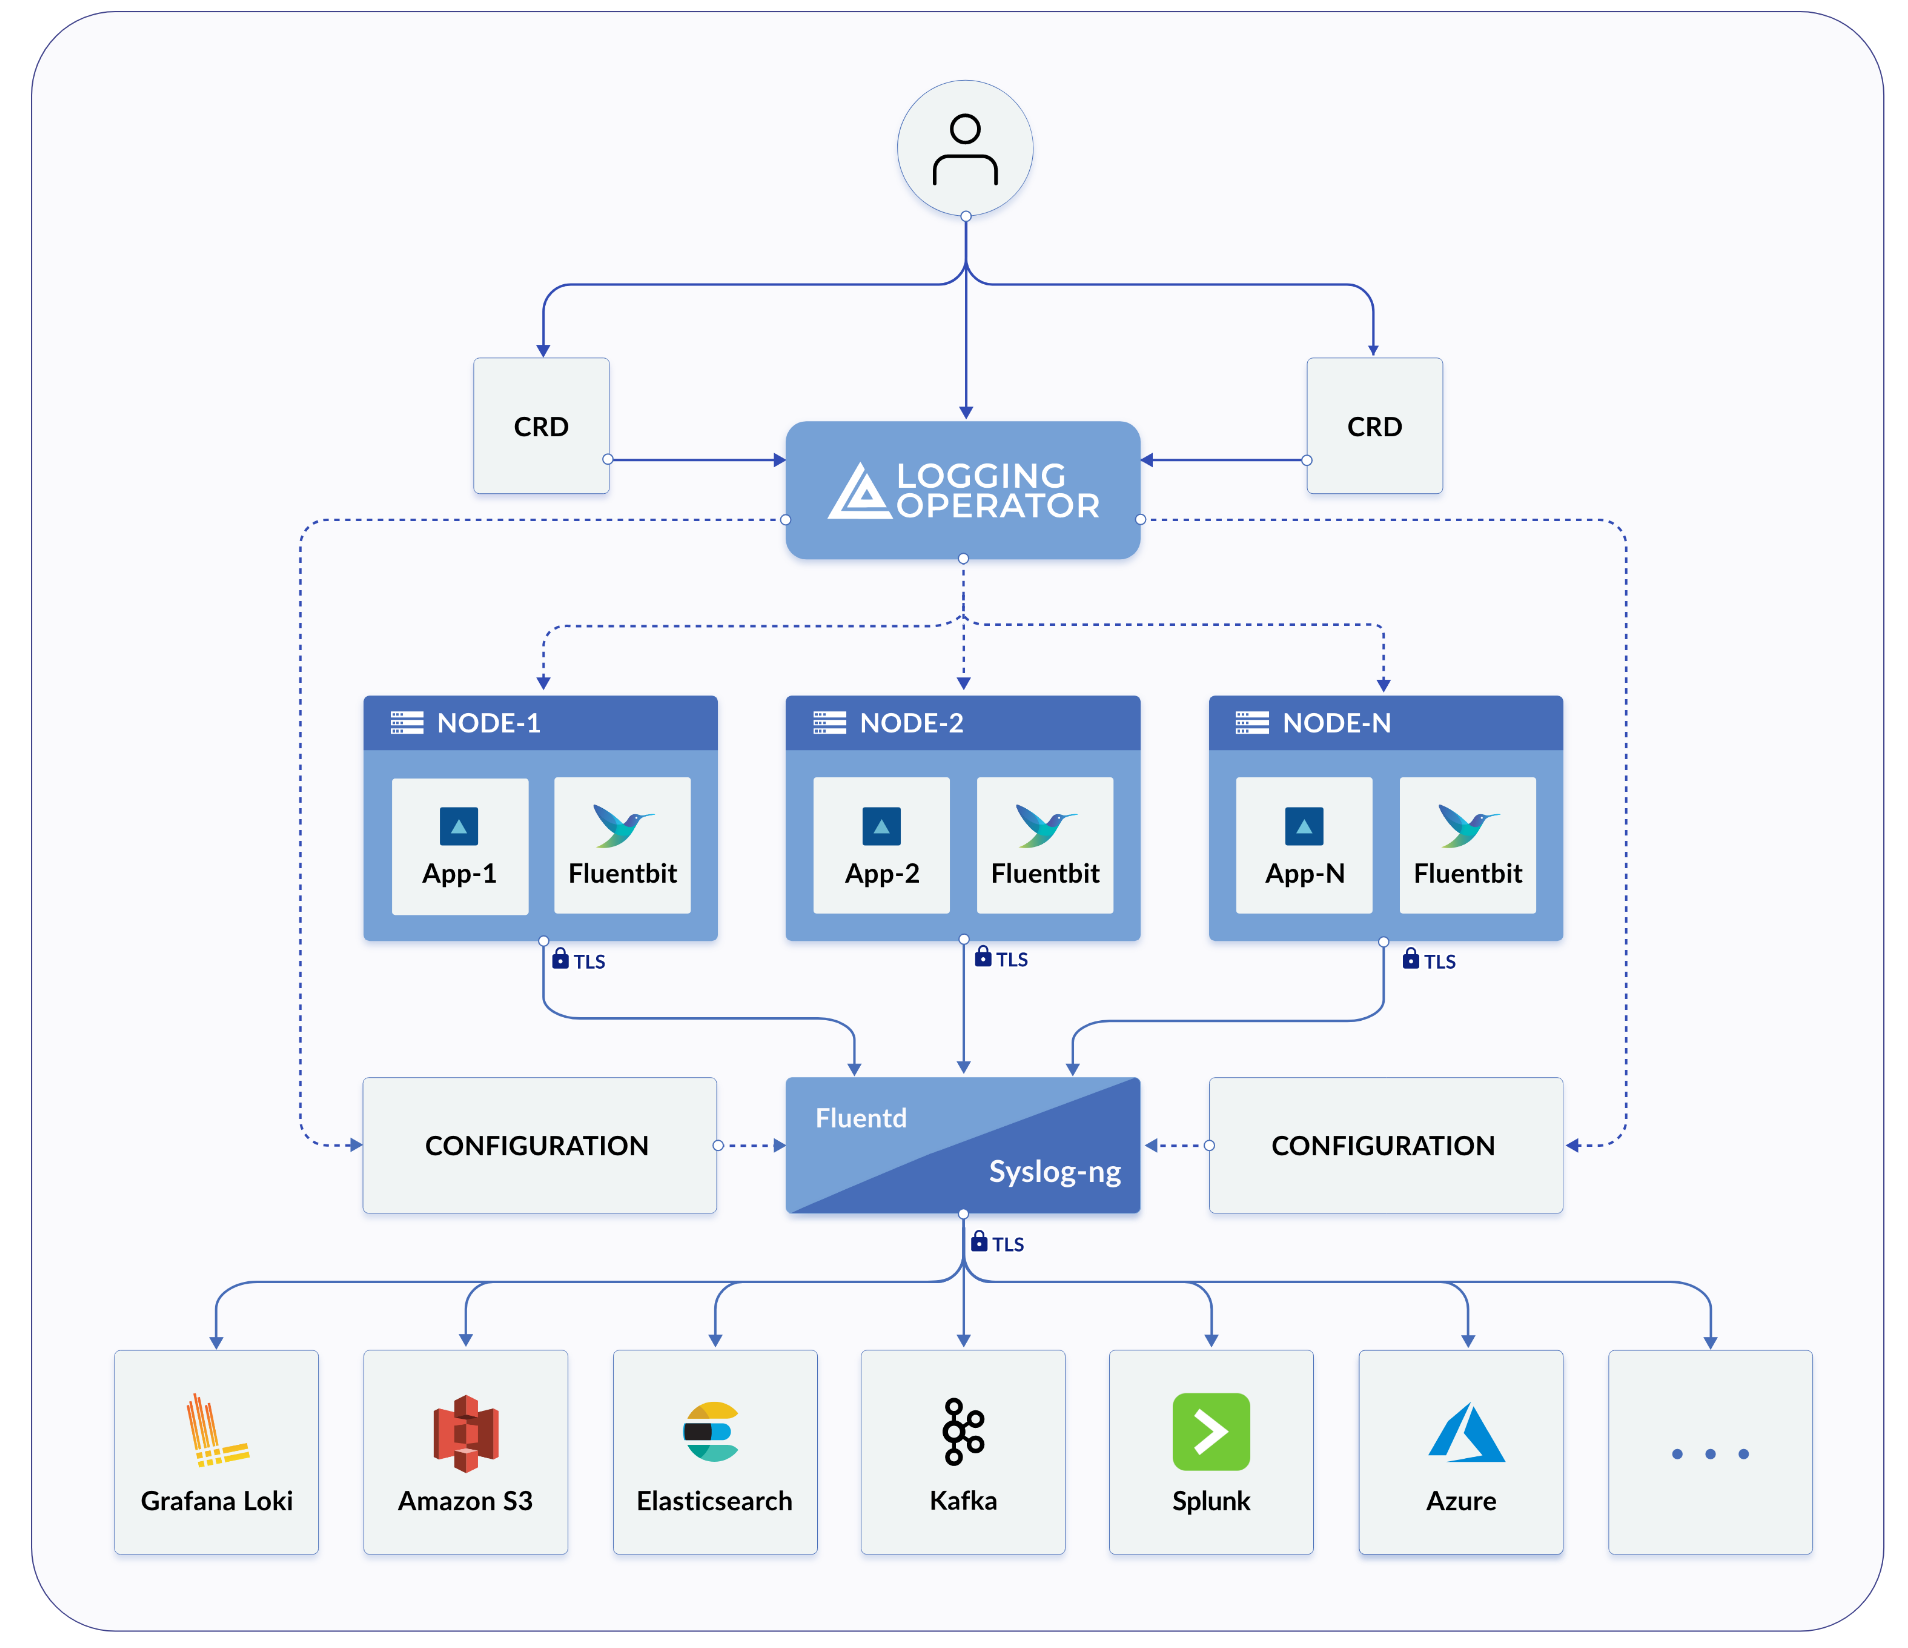
在 Harvester 的實踐中,Logging(日誌記錄)、Audit(稽核)和 Event(事件)共享一個架構,Logging 是基礎設施,而 Audit 和 Event 建立在其上。
日誌記錄
Harvester 日誌記錄基礎設施允許您將 Harvester 日誌聚合到外部服務,例如 Graylog、Elasticsearch、Splunk、Grafana Loki 等。
收集的日誌
以下是收集的日誌列表:
- 所有叢集
Pod的日誌 - 每個
節點的核心日誌 - 來自每個節點的特定 systemd 服務的日誌
rke2-serverrke2-agentrancherdrancher-system-agentwickediscsid
使用者可以配置和修改聚合日誌的發送位置,以及一些基本過濾。不支援更改收集哪些日誌。
配置日誌資源
Logging Operator 底層是 Fluentd 和 Fluent Bit,負責日誌收集和路由。
如有需要,您可以修改分配給這些元件的資源量。
從 UI
- 前往 Advanced(進階) > Addons(附加元件)頁面並選擇 rancher-logging 附加元件。
- 從 Fluentbit 標籤頁,更改資源請求和限制。
- 從 Fluentd 標籤頁,更改資源請求和限制。
- 完成 rancher-logging 附加元件的設定配置後,選擇 Save(儲存)。
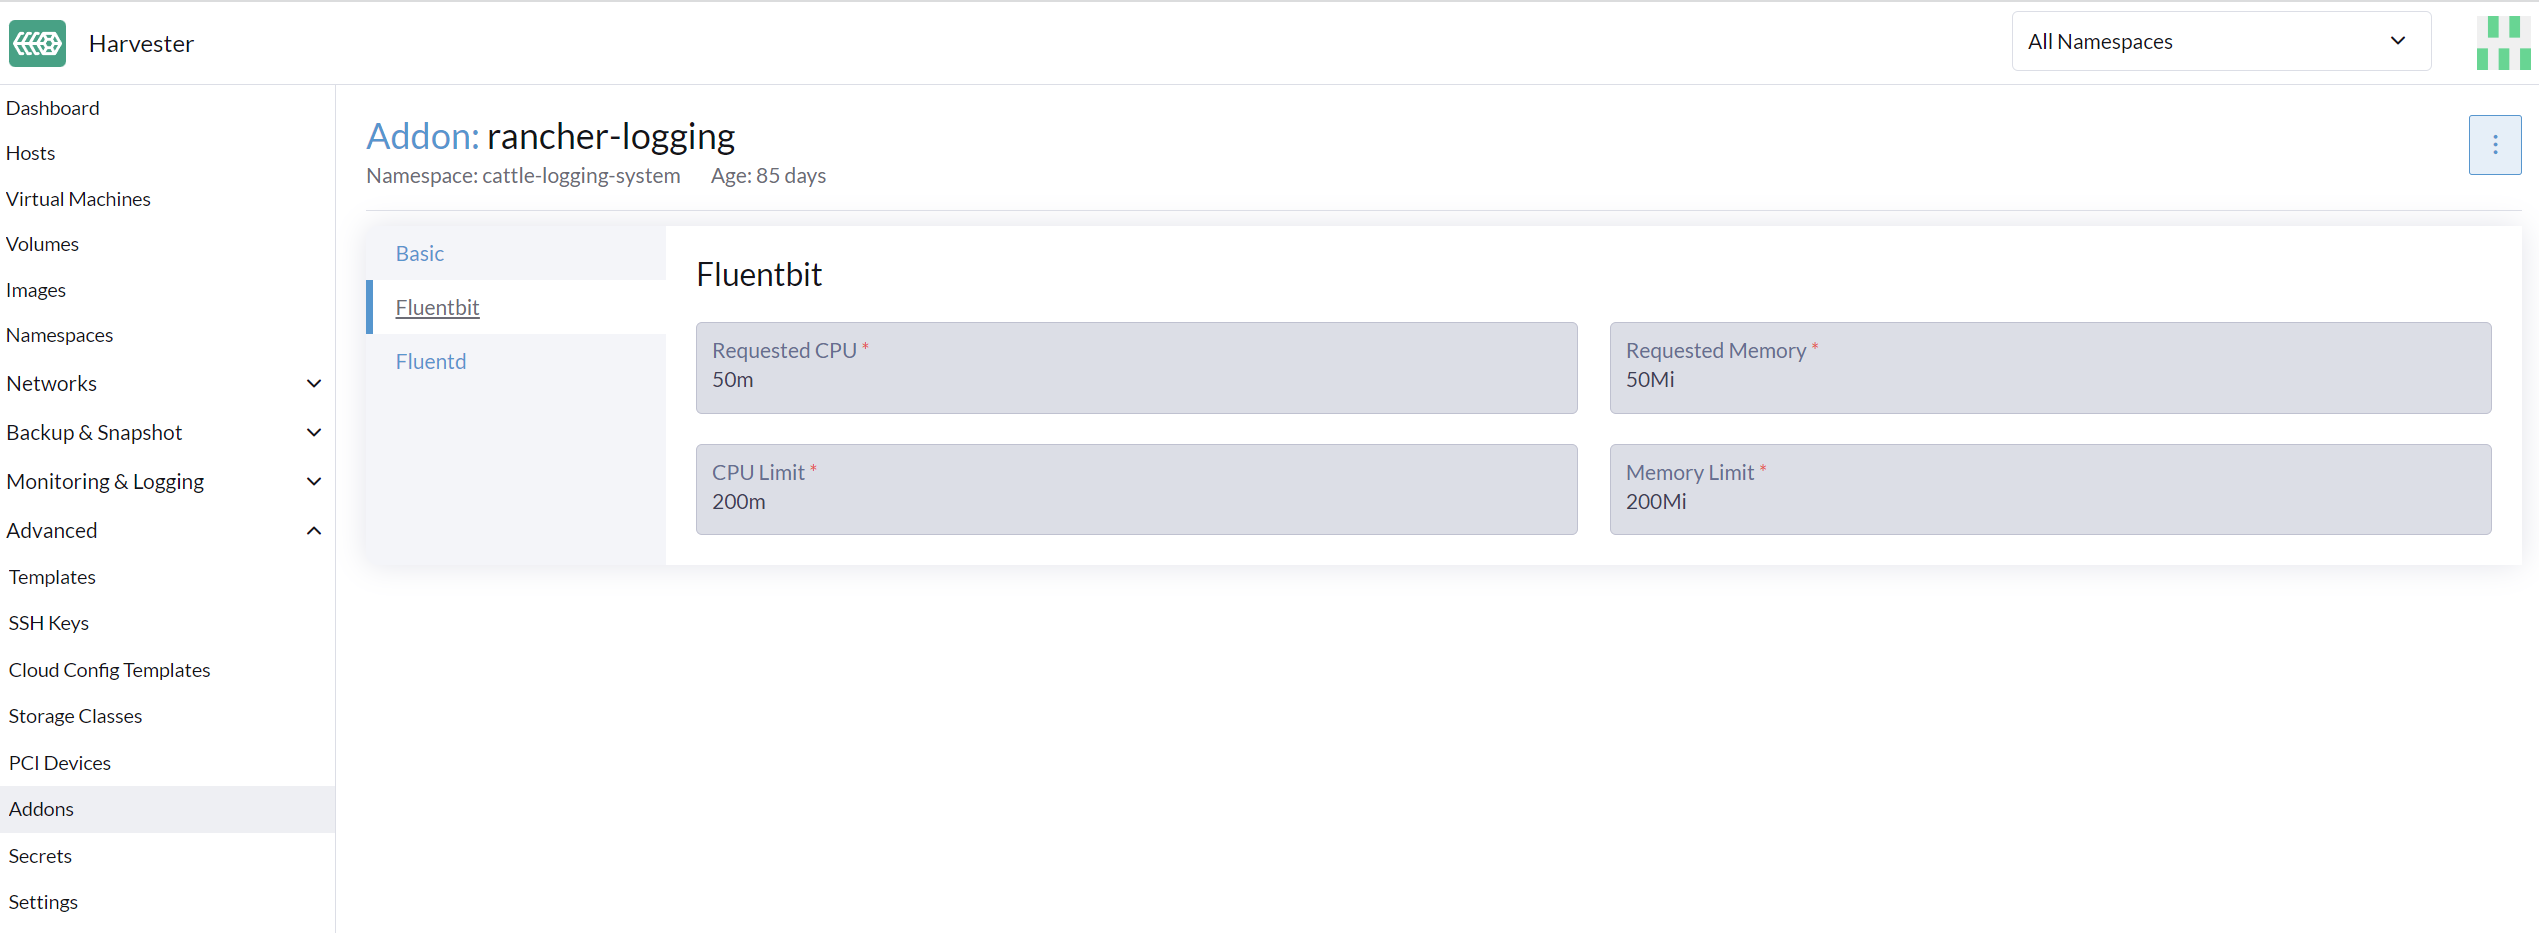
UI 配置僅在 rancher-logging 附加元件啟用時可見。
從 CLI
您可以使用以下 kubectl 命令來更改 rancher-logging 附加元件的資源配置:kubectl edit addons.harvesterhci.io -n cattle-logging-system rancher-logging。
資源路徑和預設值如下。
apiVersion: harvesterhci.io/v1beta1
kind: Addon
metadata:
  name: rancher-logging
  namespace: cattle-logging-system
spec:
  valuesContent: |
    fluentbit:
      resources:
        limits:
          cpu: 200m
          memory: 200Mi
        requests:
          cpu: 50m
          memory: 50Mi
    fluentd:
      resources:
        limits:
          cpu: 1000m
          memory: 800Mi
        requests:
          cpu: 100m
          memory: 200Mi
您仍然可以在附加元件停用時進行配置調整。但是,這些更改僅在您重新啟用附加元件時才會生效。
懸空資源檢查
自 v1.5.0 起可用
啟用 rancher-logging 附加元件時,您可能會遇到以下錯誤:
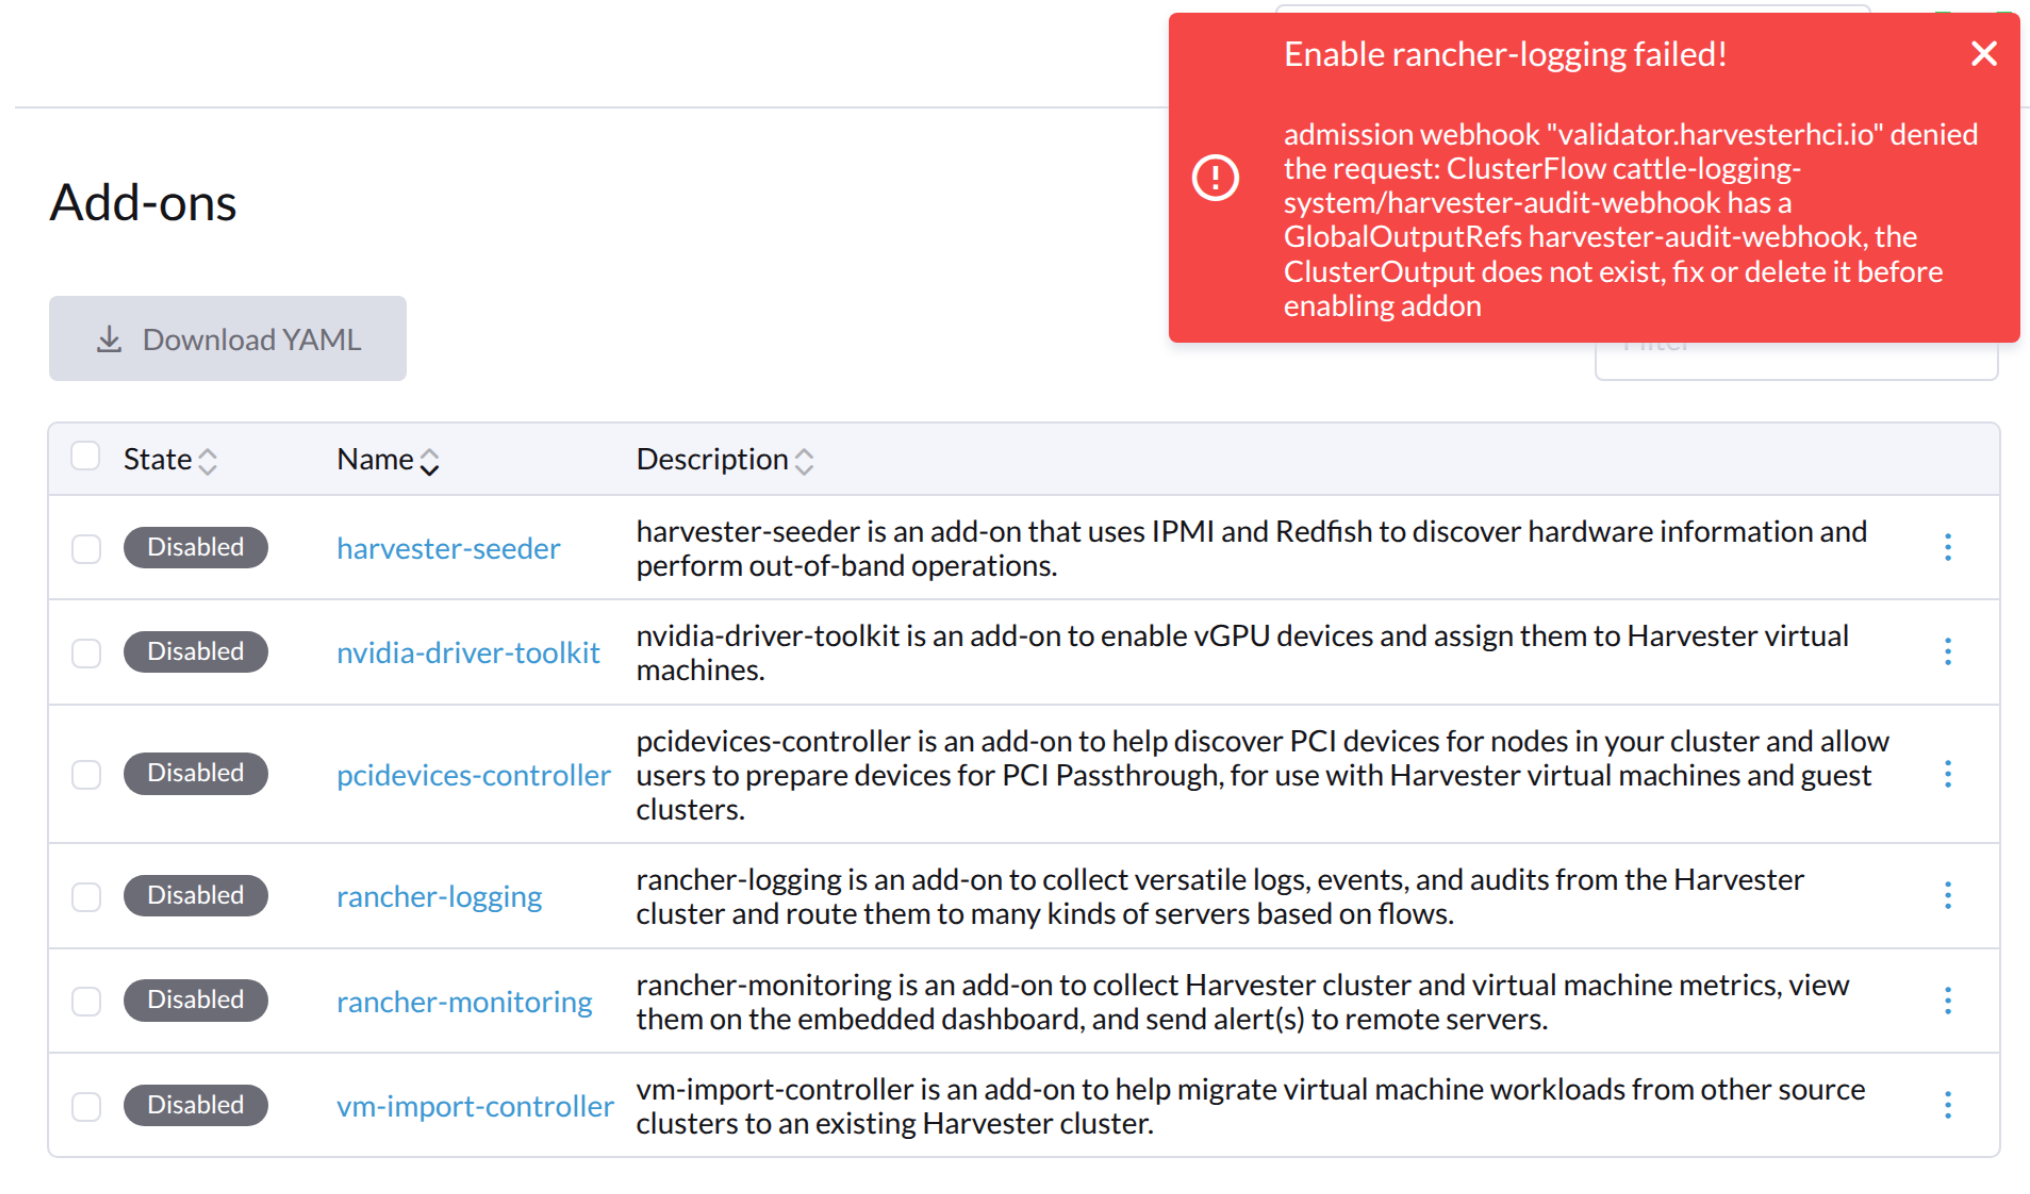
您還可能觀察到與附加元件相關的部署未完全展開。
為防止錯誤再次發生,請在啟用附加元件之前執行以下操作:
- 更新或刪除受影響的懸空資源。
- 將註解
harvesterhci.io/skipRancherLoggingAddonWebhookCheck: "true"添加到附加元件。
配置日誌目的地
日誌記錄操作由 Logging Operator 支援,並使用 Fluentd 資源控制,特別是 Flow 和 ClusterFlow 以及 Outputs 和 ClusterOutput。您可以透過將這些 CRD 套用到 Harvester 叢集來路由和過濾日誌。
將新的 Outputs 和 Flows 套用到叢集時,logging operator 可能需要一些時間才能有效地套用它們。因此,請等待幾分鐘讓日誌開始流動。
叢集級與命名空間級
在路由日誌時,了解 ClusterFlow 與 Flow 以及 ClusterOutput 與 Output 之間的區別非常重要。叢集級和非叢集級版本之間的主要區別在於非叢集級版本是命名空間範圍的。
這最大的影響是 Flows 只能存取同一命名空間內的 Outputs,但仍可以存取任何 ClusterOutput。
有關更多資訊,請參閱文件:
從 UI
UI 圖片是針對 Output 和 Flow 的,其配置過程與叢集級對應物幾乎相同。任何差異將在以下步驟中註明。
建立 Outputs
- 選擇建立新
Output或ClusterOutput的選項。 - 如果建立
Output,請選擇所需的命名空間。 - 為資源添加名稱。
- 選擇日誌類型。
- 選擇日誌輸出類型。
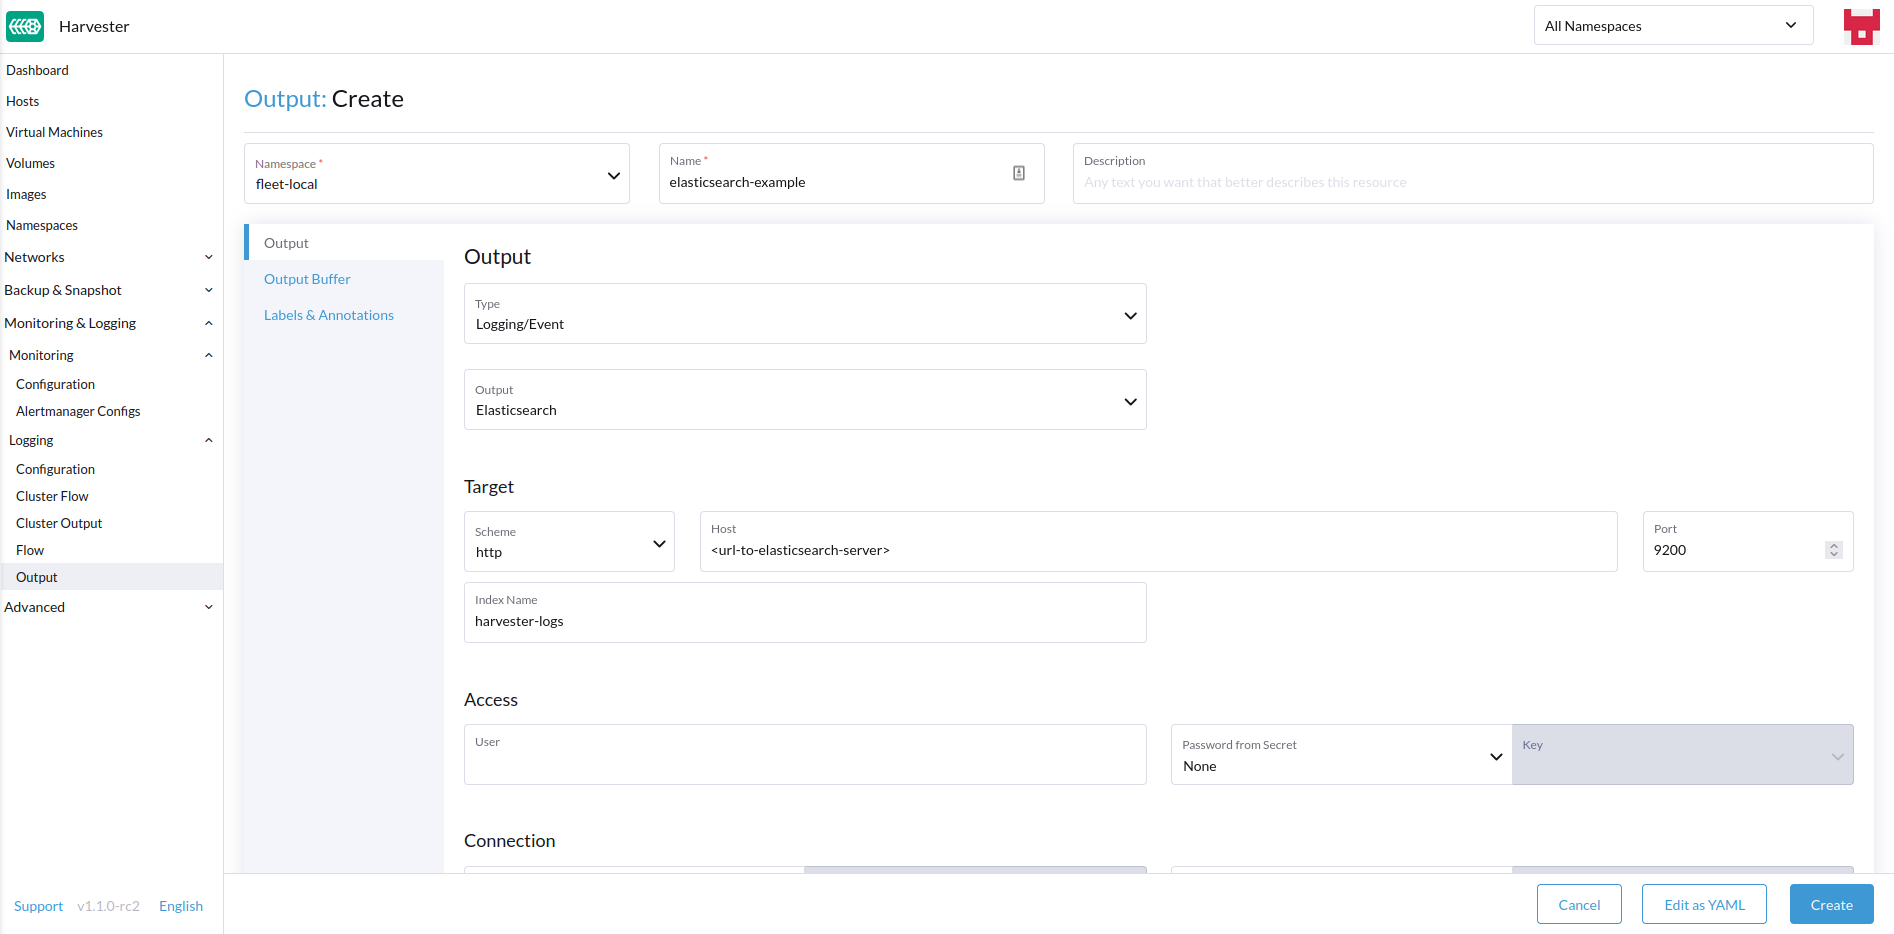
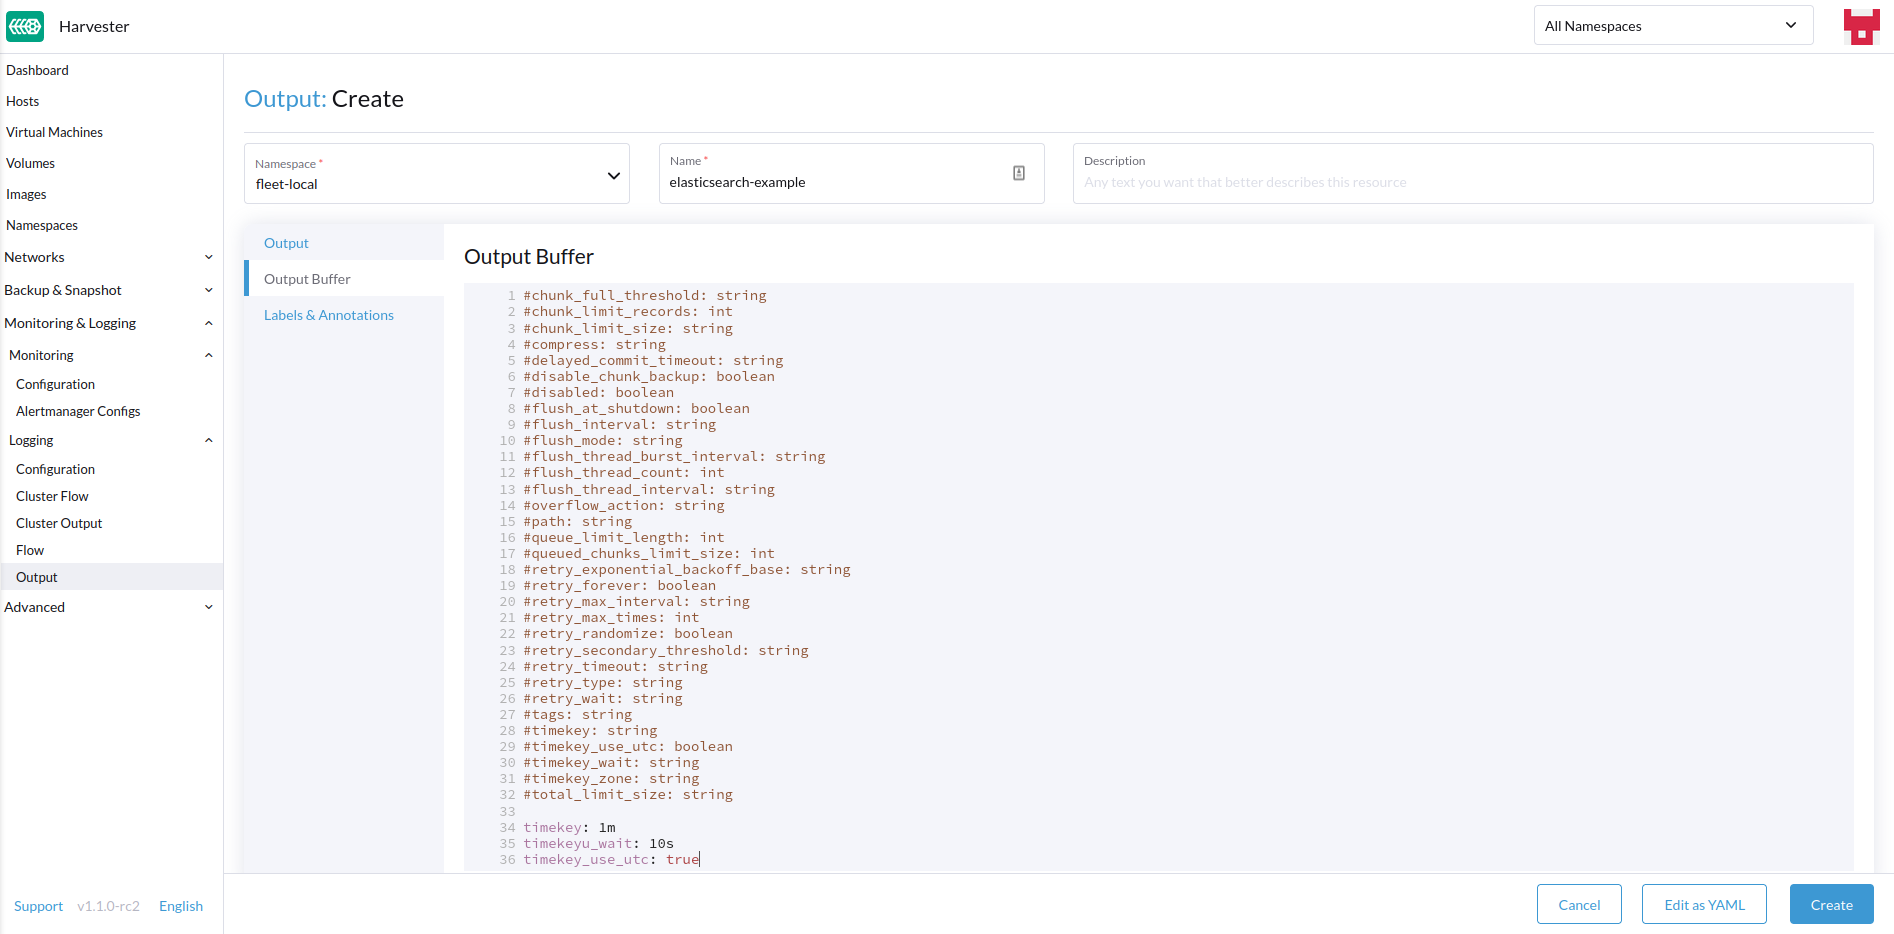
- 如有必要,配置輸出緩衝區。
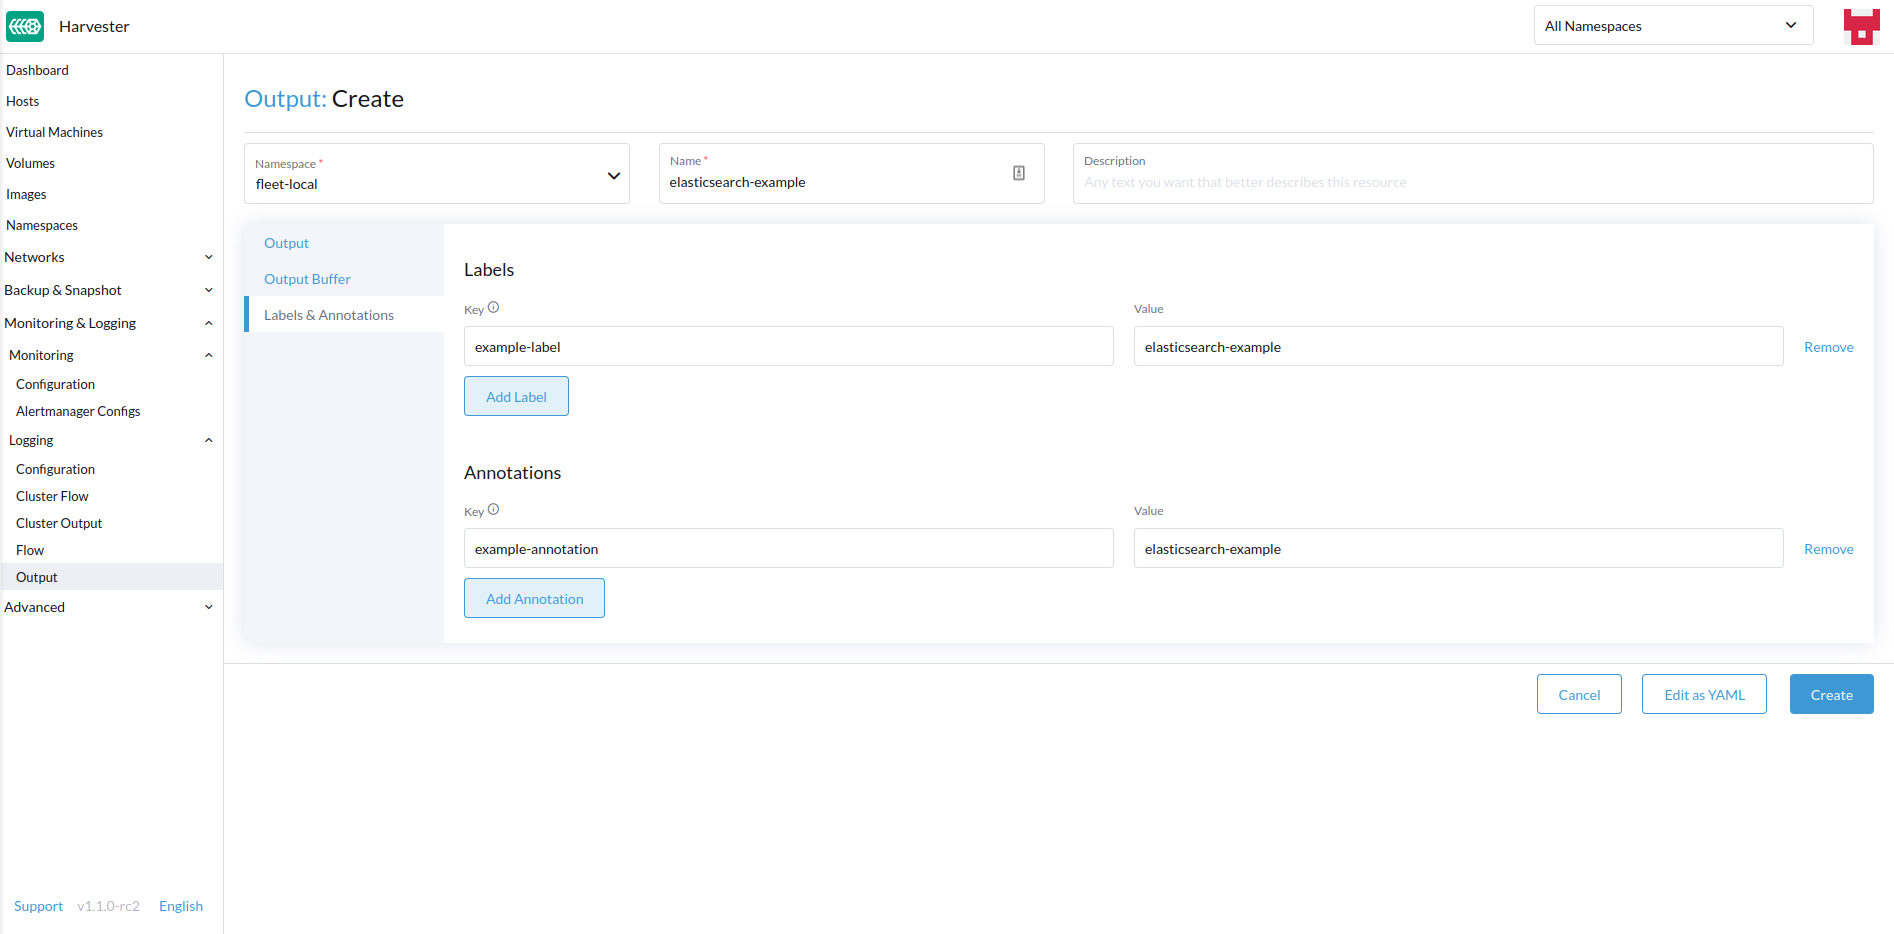
- 添加任何標籤或註解。
- 完成後,點擊右下角的
Create(建立)。
根據選擇的輸出(Splunk、Elasticsearch 等),表單中會有額外的欄位需要指定。
Output
表單顯示所選 output 可用的欄位。
Output Buffer
編輯器允許您使用各種欄位描述首選的輸出緩衝區行為。
Labels & Annotations
您可以將標籤和註解附加到建立的資源。
建立 Flows
- 選擇建立新
Flow或ClusterFlow的選項。 - 如果建立
Flow,請選擇所需的命名空間。 - 為資源添加名稱。
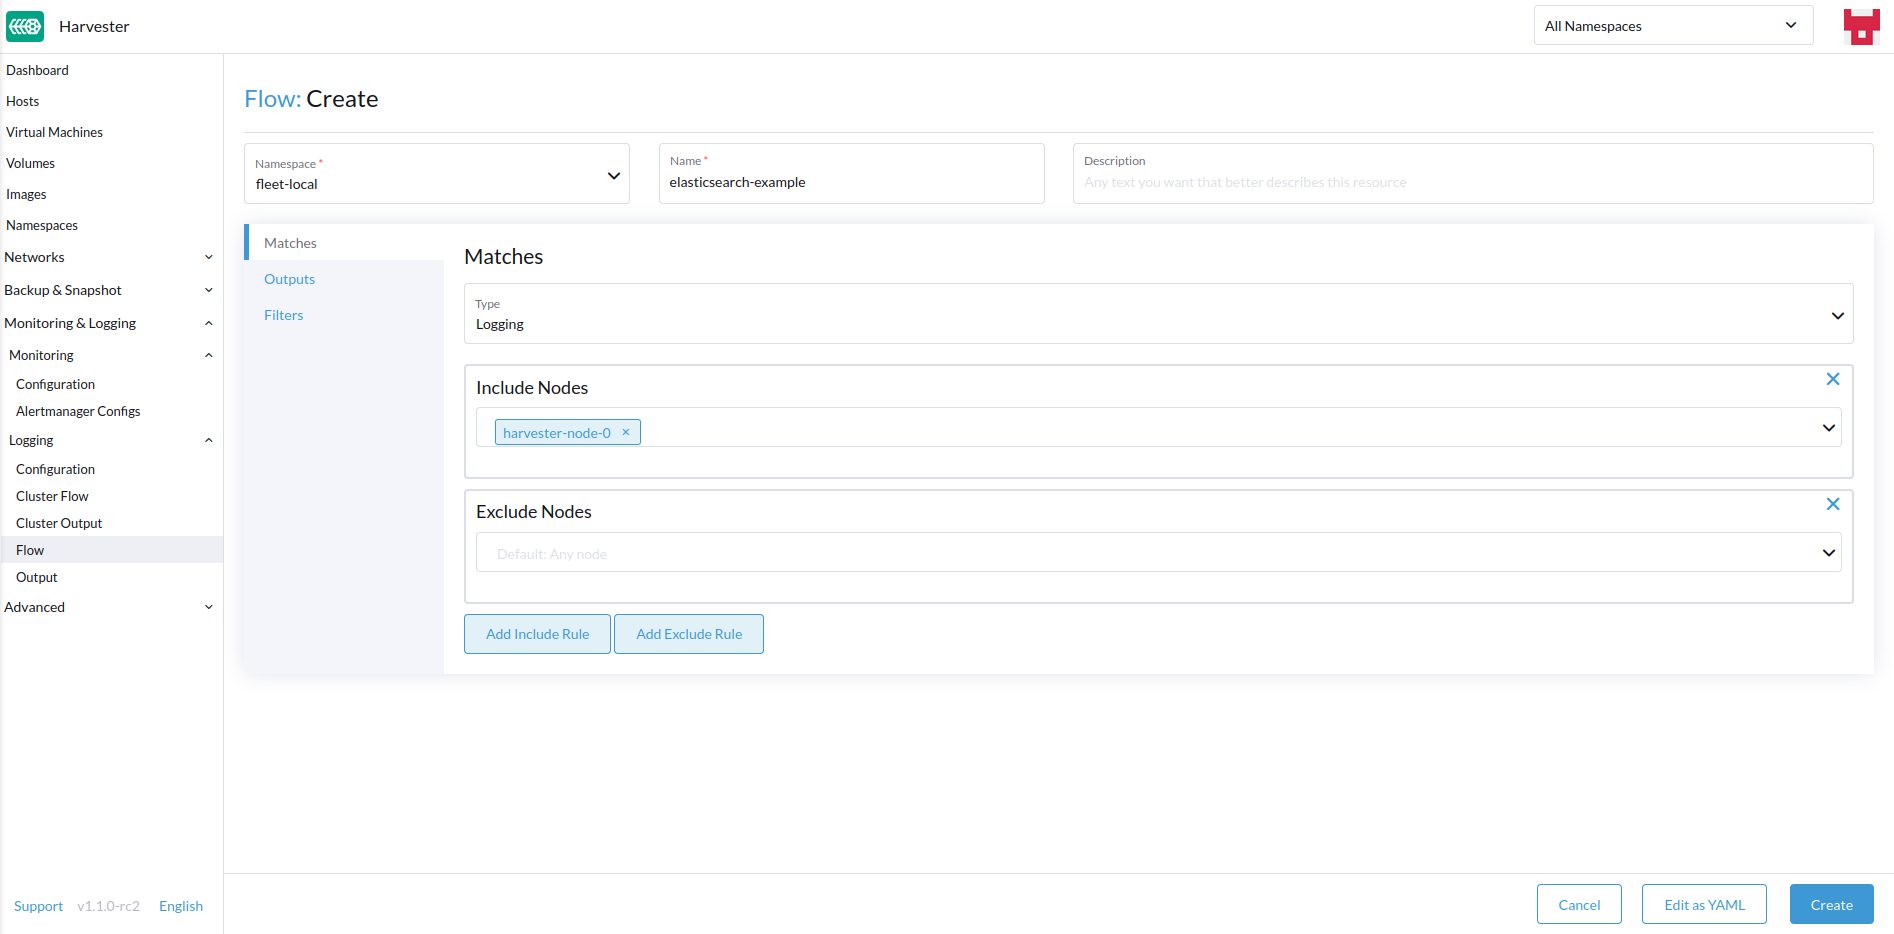
- 選擇要包含或排除其日誌的任何節點。
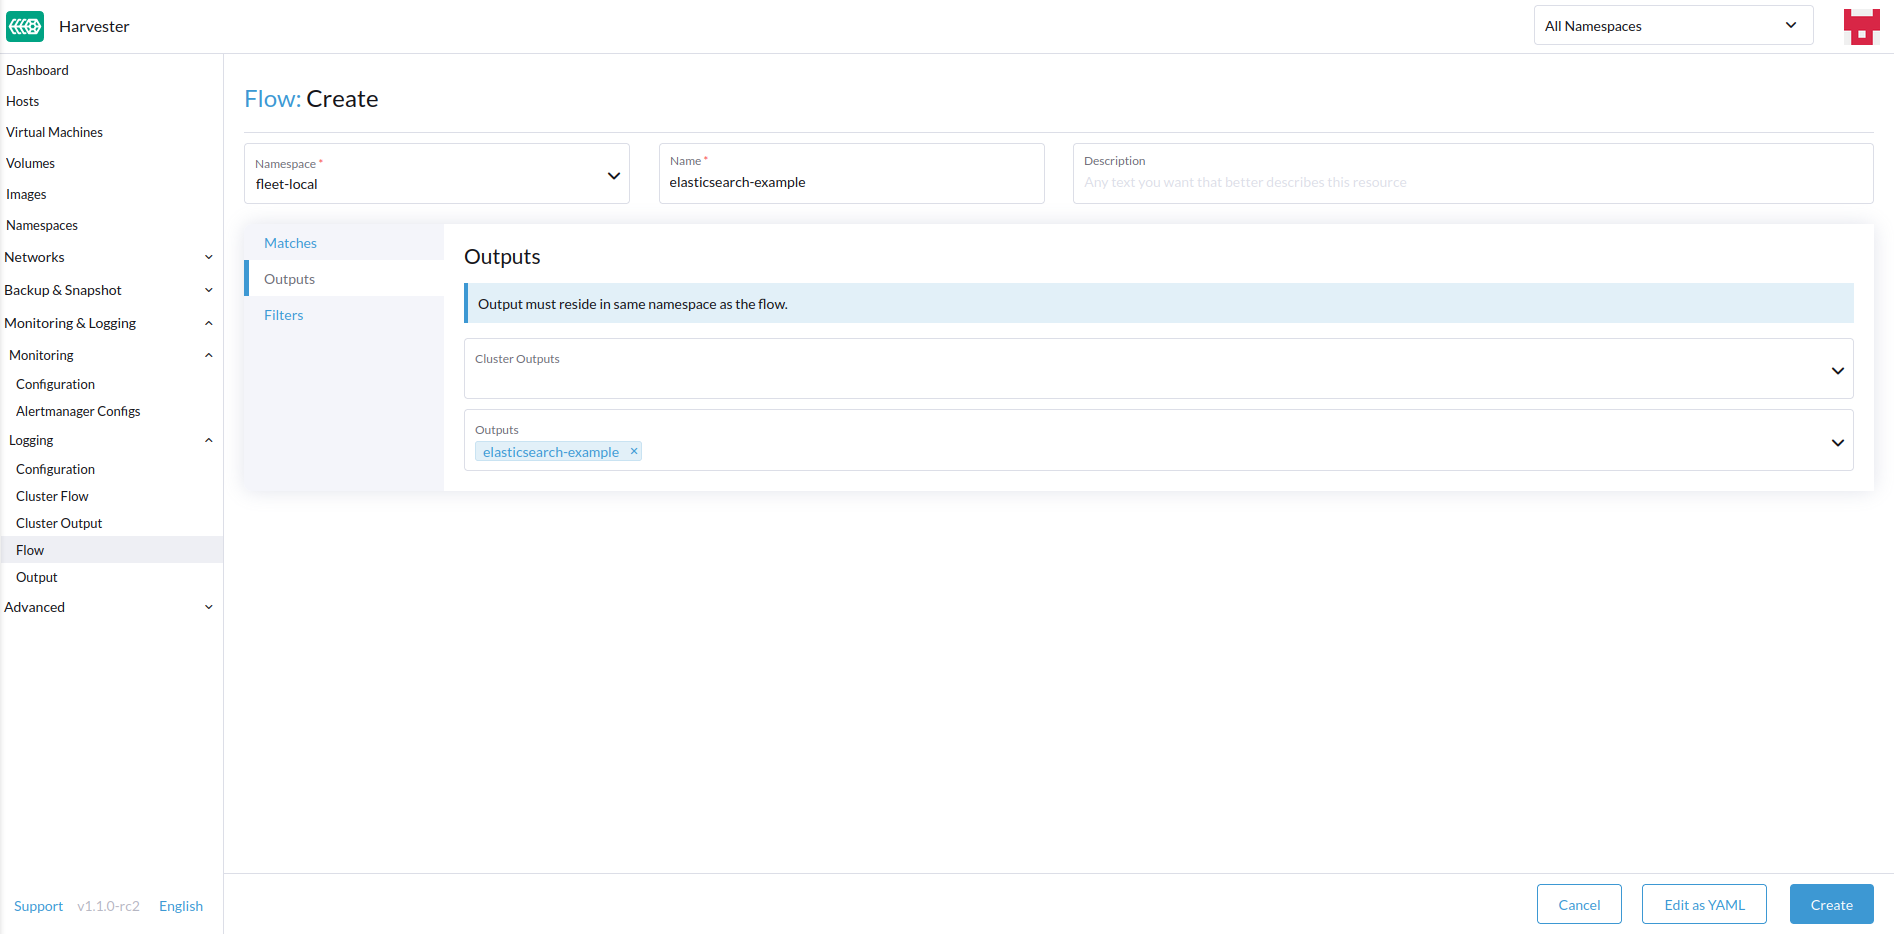
- 選擇目標
Outputs和ClusterOutputs。
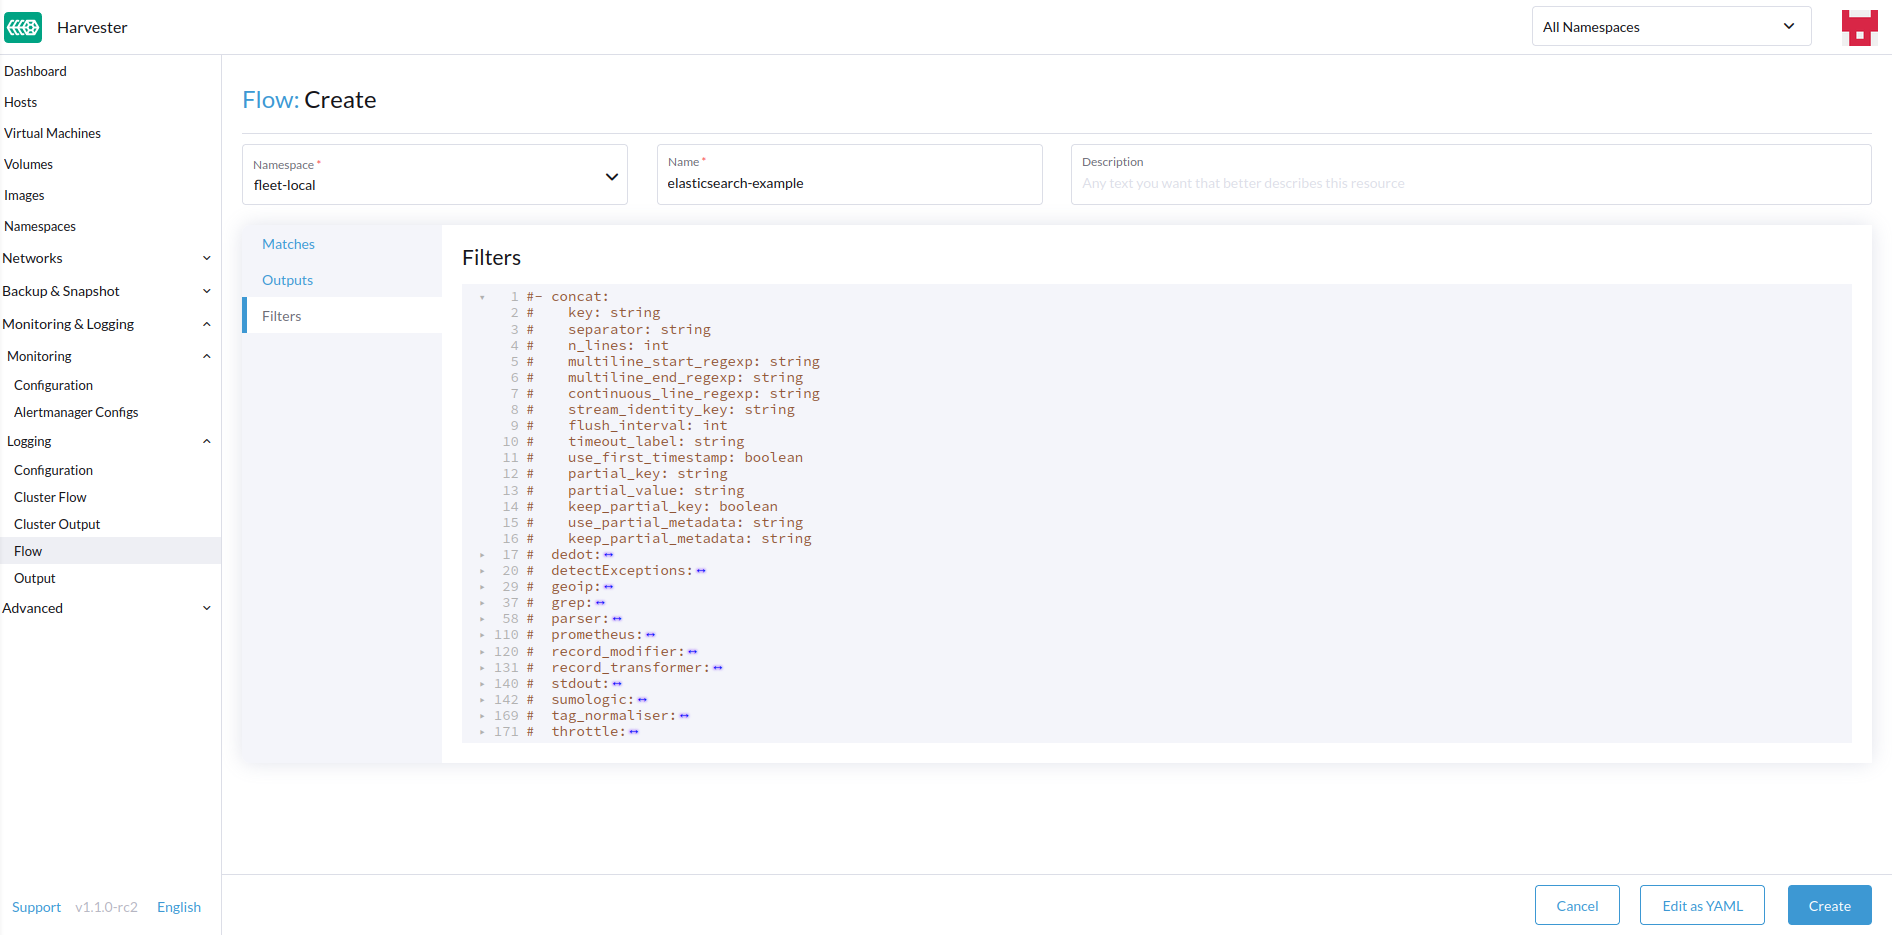
- 如需要,添加任何過濾器。
- 完成後,點擊左下角的
Create(建立)。
Matches
Matches 允許您過濾要包含在 Flow 中的日誌。表單僅允許您包含或排除節點日誌,但如有需要,您可以透過選擇 Edit as YAML(以 YAML 編輯)來添加資源支援的其他匹配規則。
有關 match 指令的更多資訊,請參閱 Match statement。
Outputs
Outputs 允許您選擇一個或多個 OutputRefs 來發送聚合的日誌。建立或編輯 Flow / ClusterFlow 時,使用者必須選擇至少一個 Output。
必須至少有一個現有的 ClusterOutput 或 Output 可以附加到 flow,否則您將無法建立/編輯 flow。
Filters
Filters 允許您轉換、處理和變更日誌。有關更多資訊,請參閱支援的 filters 列表。
從 CLI
要透過命令列配置日誌路由,您只需為相關資源定義 YAML 檔案:
# elasticsearch-logging.yaml
apiVersion: logging.banzaicloud.io/v1beta1
kind: Output
metadata:
  name: elasticsearch-example
  namespace: fleet-local
  labels:
    example-label: elasticsearch-example
  annotations:
    example-annotation: elasticsearch-example
spec:
  elasticsearch:
    host: <url-to-elasticsearch-server>
    port: 9200
---
apiVersion: logging.banzaicloud.io/v1beta1
kind: Flow
metadata:
  name: elasticsearch-example
  namespace: fleet-local
spec:
  match:
    - select: {}
  globalOutputRefs:
    - elasticsearch-example
然後套用它們:
kubectl apply -f elasticsearch-logging.yaml
參照 Secrets
您可以使用以下任何方法定義 secret 值(YAML 格式):
最簡單的是使用 value 鍵,它是所需 secret 的簡單字串值。此方法僅應用於測試,絕不應在生產環境中使用:
aws_key_id:
  value: "secretvalue"
下一個是使用 valueFrom,它允許透過名稱和鍵對參照 secret 中的特定值:
aws_key_id:
  valueFrom:
    secretKeyRef:
      name: <kubernetes-secret-name>
      key: <kubernetes-secret-key>
某些外掛程式需要從檔案讀取而不是簡單地從 secret 接收值(這通常是 CA 憑證檔案的情況)。在這些情況下,您需要使用 mountFrom,它會將 secret 作為檔案掛載到底層 fluentd 部署,並將外掛程式指向該檔案。valueFrom 和 mountFrom 物件看起來相同:
tls_cert_path:
  mountFrom:
    secretKeyRef:
      name: <kubernetes-secret-name>
      key: <kubernetes-secret-key>
有關更多資訊,請參閱 Secret definition。
Outputs 範例
- Elasticsearch
- Graylog
- Splunk
- Loki
對於最簡單的部署,您可以使用 docker 在本地系統上部署 Elasticsearch:
sudo docker run --name elasticsearch -p 9200:9200 -p 9300:9300 -e xpack.security.enabled=false -e node.name=es01 -e discovery.type=single-node -it docker.elastic.co/elasticsearch/elasticsearch:8.16.6
要將 Elasticsearch 與 Harvester v1.5.0 一起使用,請確保 Elasticsearch 伺服器執行的是 8.11.0 或更高版本。
當 rancher-logging-root-fluentd-0 pod 報告錯誤(例如 #0 unexpected error error_class=Elastic::Transport::Transport::Error error="no address for http (Resolv::ResolvError)" Client can't recognise the server.)時,您必須升級 Elasticsearch。
確保您已將 vm.max_map_count 設定為 >= 262144,否則上述 docker 命令將失敗。Elasticsearch 伺服器啟動後,您可以為 ClusterOutput 和 ClusterFlow 建立 yaml 檔案:
cat << EOF > elasticsearch-example.yaml
apiVersion: logging.banzaicloud.io/v1beta1
kind: ClusterOutput
metadata:
  name: elasticsearch-example
  namespace: cattle-logging-system
spec:
  elasticsearch:
    host: 192.168.0.119
    port: 9200
    buffer:
      timekey: 1m
      timekey_wait: 30s
      timekey_use_utc: true
---
apiVersion: logging.banzaicloud.io/v1beta1
kind: ClusterFlow
metadata:
  name: elasticsearch-example
  namespace: cattle-logging-system
spec:
  match:
    - select: {}
  globalOutputRefs:
    - elasticsearch-example
EOF
並套用檔案:
kubectl apply -f elasticsearch-example.yaml
在等待一段時間讓 logging operator 套用資源後,您可以測試日誌是否正在流動:
$ curl localhost:9200/fluentd/_search
{
  "took": 1,
  "timed_out": false,
  "_shards": {
    "total": 5,
    "successful": 5,
    "skipped": 0,
    "failed": 0
  },
  "hits": {
    "total": 11603,
    "max_score": 1,
    "hits": [
      {
        "_index": "fluentd",
        "_type": "fluentd",
        "_id": "yWHr0oMBXcBggZRJgagY",
        "_score": 1,
        "_source": {
          "stream": "stderr",
          "logtag": "F",
          "message": "I1013 02:29:43.020384       1 csi_handler.go:248] Attaching \"csi-974b4a6d2598d8a7a37b06d06557c428628875e077dabf8f32a6f3aa2750961d\"",
          "kubernetes": {
            "pod_name": "csi-attacher-5d4cc8cfc8-hd4nb",
            "namespace_name": "longhorn-system",
            "pod_id": "c63c2014-9556-40ce-a8e1-22c55de12e70",
            "labels": {
              "app": "csi-attacher",
              "pod-template-hash": "5d4cc8cfc8"
            },
            "annotations": {
              "cni.projectcalico.org/containerID": "857df09c8ede7b8dee786a8c8788e8465cca58f0b4d973c448ed25bef62660cf",
              "cni.projectcalico.org/podIP": "10.52.0.15/32",
              "cni.projectcalico.org/podIPs": "10.52.0.15/32",
              "k8s.v1.cni.cncf.io/network-status": "[{\n    \"name\": \"k8s-pod-network\",\n    \"ips\": [\n        \"10.52.0.15\"\n    ],\n    \"default\": true,\n    \"dns\": {}\n}]",
              "k8s.v1.cni.cncf.io/networks-status": "[{\n    \"name\": \"k8s-pod-network\",\n    \"ips\": [\n        \"10.52.0.15\"\n    ],\n    \"default\": true,\n    \"dns\": {}\n}]",
              "kubernetes.io/psp": "global-unrestricted-psp"
            },
            "host": "harvester-node-0",
            "container_name": "csi-attacher",
            "docker_id": "f10e4449492d4191376d3e84e39742bf077ff696acbb1e5f87c9cfbab434edae",
            "container_hash": "sha256:03e115718d258479ce19feeb9635215f98e5ad1475667b4395b79e68caf129a6",
            "container_image": "docker.io/longhornio/csi-attacher:v3.4.0"
          }
        }
      },
...
    ]
  }
}
您可以按照這裡的說明透過 Graylog 部署和檢視叢集日誌:
apiVersion: logging.banzaicloud.io/v1beta1
kind: ClusterFlow
metadata:
  name: "all-logs-gelf-hs"
  namespace: "cattle-logging-system"
spec:
  globalOutputRefs:
    - "example-gelf-hs"
---
apiVersion: logging.banzaicloud.io/v1beta1
kind: ClusterOutput
metadata:
  name: "example-gelf-hs"
  namespace: "cattle-logging-system"
spec:
  gelf:
    host: "192.168.122.159"
    port: 12202
    protocol: "udp"
您可以按照這裡的說明透過 Splunk 部署和檢視叢集日誌。
apiVersion: logging.banzaicloud.io/v1beta1
kind: ClusterOutput
metadata:
  name: harvester-logging-splunk
  namespace: cattle-logging-system
spec:
  splunkHec:
    hec_host: 192.168.122.101
    hec_port: 8088
    insecure_ssl: true
    index: harvester-log-index
    hec_token:
      valueFrom:
        secretKeyRef:
          key: HECTOKEN
          name: splunk-hec-token2
    buffer:
      chunk_limit_size: 3MB
      timekey: 2m
      timekey_wait: 1m
---
apiVersion: logging.banzaicloud.io/v1beta1
kind: ClusterFlow
metadata:
  name: harvester-logging-splunk
  namespace: cattle-logging-system
spec:
  filters:
    - tag_normaliser: {}
  match:
  globalOutputRefs:
    - harvester-logging-splunk
您可以按照 logging HEP 中的說明透過 Grafana Loki 部署和檢視叢集日誌。
apiVersion: logging.banzaicloud.io/v1beta1
kind: ClusterFlow
metadata:
  name: harvester-loki
  namespace: cattle-logging-system
spec:
  match:
    - select: {}
  globalOutputRefs:
    - harvester-loki
---
apiVersion: logging.banzaicloud.io/v1beta1
kind: ClusterOutput
metadata:
  name: harvester-loki
  namespace: cattle-logging-system
spec:
  loki:
    url: http://loki-stack.cattle-logging-system.svc:3100
    extra_labels:
      logOutput: harvester-loki
稽核
Harvester 收集 Kubernetes audit(稽核)並能夠將 audit 發送到各種類型的日誌伺服器。
指導 kube-apiserver 的策略檔案在這裡。
稽核定義
在 kubernetes 中,audit(稽核)資料由 kube-apiserver 根據定義的策略產生。
...
Audit policy(稽核策略)
稽核策略定義了應該記錄哪些事件以及它們應該包含哪些資料的規則。稽核策略物件結構在 audit.k8s.io API 群組中定義。當事件被處理時,它會按順序與規則列表進行比較。第一個匹配的規則設定事件的稽核級別。定義的稽核級別為:

None - 不記錄與此規則匹配的事件。
Metadata - 記錄請求元資料(請求使用者、時間戳記、資源、動詞等),但不記錄請求或回應主體。
Request - 記錄事件元資料和請求主體,但不記錄回應主體。這不適用於非資源請求。
RequestResponse - 記錄事件元資料、請求和回應主體。這不適用於非資源請求。
稽核日誌格式
Kubernetes 中的稽核日誌格式
Kubernetes apiserver 使用以下 JSON 格式將稽核記錄到本地檔案。
{
  "kind":"Event",
  "apiVersion":"audit.k8s.io/v1",
  "level":"Metadata",
  "auditID":"13d0bf83-7249-417b-b386-d7fc7c024583",
  "stage":"RequestReceived",
  "requestURI":"/apis/flowcontrol.apiserver.k8s.io/v1beta2/prioritylevelconfigurations?fieldManager=api-priority-and-fairness-config-producer-v1",
  "verb":"create",
  "user":{"username":"system:apiserver","uid":"d311c1fe-2d96-4e54-a01b-5203936e1046","groups":["system:masters"]},
  "sourceIPs":["::1"],
  "userAgent":"kube-apiserver/v1.24.7+rke2r1 (linux/amd64) kubernetes/e6f3597",
  "objectRef":{"resource":"prioritylevelconfigurations",
  "apiGroup":"flowcontrol.apiserver.k8s.io",
  "apiVersion":"v1beta2"},
  "requestReceivedTimestamp":"2022-10-19T18:55:07.244781Z",
  "stageTimestamp":"2022-10-19T18:55:07.244781Z"
}
發送到日誌伺服器之前的稽核日誌格式
Harvester 在發送到日誌伺服器之前保持 audit 日誌不變。
稽核日誌 Output/ClusterOutput
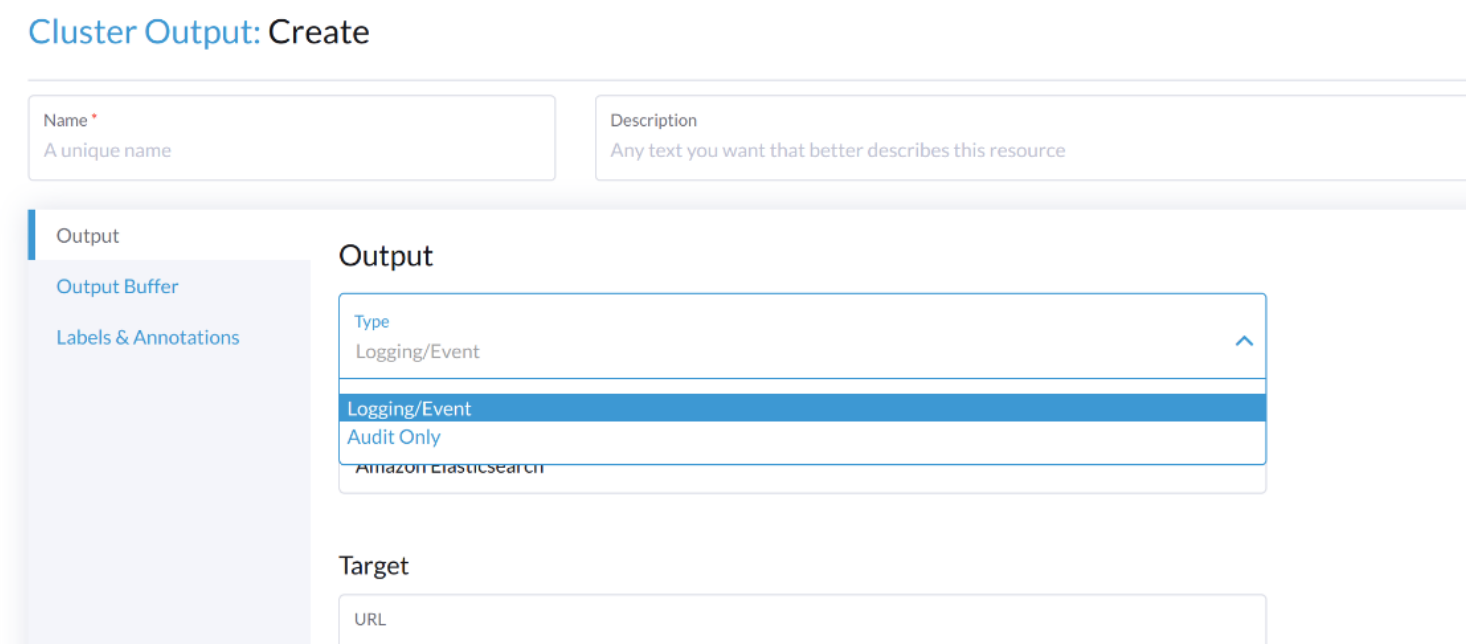
要輸出稽核相關日誌,Output/ClusterOutput 需要將 loggingRef 的值設為 harvester-kube-audit-log-ref。
當您從 Harvester 儀表板配置時,該欄位會自動添加。
從 Type(類型)下拉式選單中選擇 Audit Only(僅稽核)類型。
當您從 CLI 配置時,請手動添加該欄位。
範例:
apiVersion: logging.banzaicloud.io/v1beta1
kind: ClusterOutput
metadata:
  name: "harvester-audit-webhook"
  namespace: "cattle-logging-system"
spec:
  http:
    endpoint: "http://192.168.122.159:8096/"
    open_timeout: 3
    format:
      type: "json"
    buffer:
      chunk_limit_size: 3MB
      timekey: 2m
      timekey_wait: 1m
  loggingRef: harvester-kube-audit-log-ref   # 此參照是固定的,必須在此處
稽核日誌 Flow/ClusterFlow
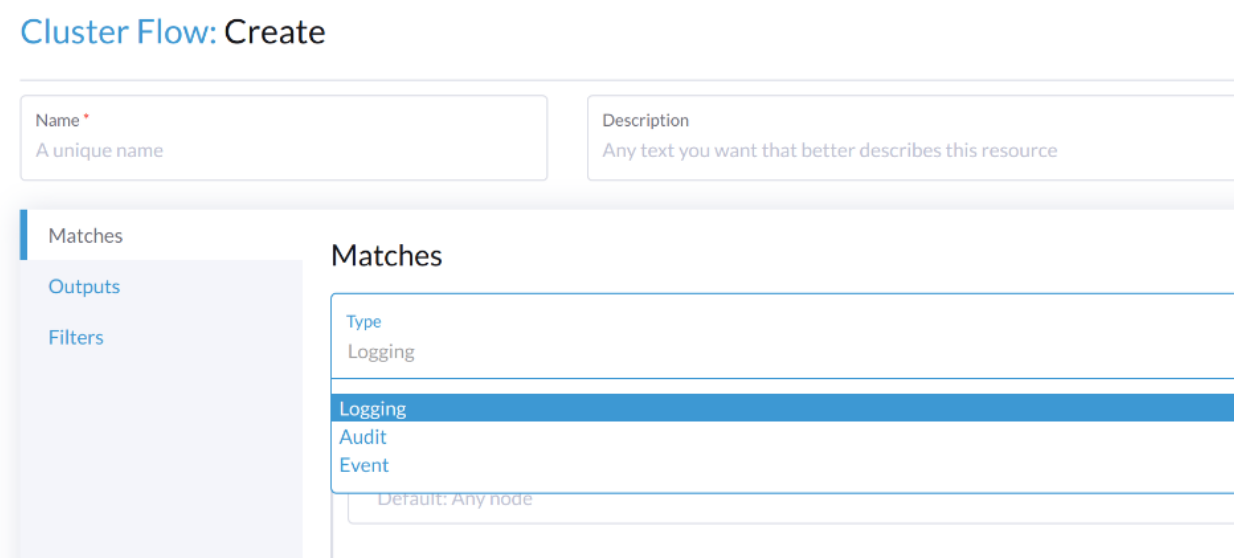
要路由稽核相關日誌,Flow/ClusterFlow 需要將 loggingRef 的值設為 harvester-kube-audit-log-ref。
當您從 Harvester 儀表板配置時,該欄位會自動添加。
選擇 Audit(稽核)類型。
當您從 CLI 配置時,請手動添加該欄位。
範例:
apiVersion: logging.banzaicloud.io/v1beta1
kind: ClusterFlow
metadata:
  name: "harvester-audit-webhook"
  namespace: "cattle-logging-system"
spec:
  globalOutputRefs:
    - "harvester-audit-webhook"
  loggingRef: harvester-kube-audit-log-ref  # 此參照是固定的,必須在此處
Harvester
事件
Harvester 收集 Kubernetes event(事件)並能夠將 event 發送到各種類型的日誌伺服器。
事件定義
Kubernetes events(事件)是顯示叢集內部發生情況的物件,例如排程器做出了什麼決定或為什麼某些 pod 被從節點驅逐。所有核心元件和擴充功能(operators/controllers)都可以透過 API Server 建立事件。
事件與各種元件產生的日誌訊息沒有直接關係,也不受日誌詳細程度級別的影響。當元件建立事件時,它通常會發出相應的日誌訊息。事件在短時間後(通常在一小時後)由 API Server 進行垃圾回收,這意味著它們可用於了解正在發生的問題,但您必須收集它們以調查過去的事件。
事件是應用程式以及基礎設施操作在出現問題時首先要查看的內容。如果故障是早期事件的結果,或在進行事後分析時,將它們保留更長時間是必不可少的。
事件日誌格式
Kubernetes 中的事件日誌格式
一個 kubernetes event 範例:
        {
            "apiVersion": "v1",
            "count": 1,
            "eventTime": null,
            "firstTimestamp": "2022-08-24T11:17:35Z",
            "involvedObject": {
                "apiVersion": "kubevirt.io/v1",
                "kind": "VirtualMachineInstance",
                "name": "vm-ide-1",
                "namespace": "default",
                "resourceVersion": "604601",
                "uid": "1bd4133f-5aa3-4eda-bd26-3193b255b480"
            },
            "kind": "Event",
            "lastTimestamp": "2022-08-24T11:17:35Z",
            "message": "VirtualMachineInstance defined.",
            "metadata": {
                "creationTimestamp": "2022-08-24T11:17:35Z",
                "name": "vm-ide-1.170e43cbdd833b62",
                "namespace": "default",
                "resourceVersion": "604626",
                "uid": "0114f4e7-1d4a-4201-b0e5-8cc8ede202f4"
            },
            "reason": "Created",
            "reportingComponent": "",
            "reportingInstance": "",
            "source": {
                "component": "virt-handler",
                "host": "harv1"
            },
            "type": "Normal"
        },
發送到日誌伺服器之前的事件日誌格式
每個 event log 的格式為:{"stream":"","logtag":"F","message":"","kubernetes":{""}}。kubernetes event 在 message 欄位中。
{
  "stream":"stdout",
  "logtag":"F",
  "message":"{
    \\"verb\\":\\"ADDED\\",
    \\"event\\":{\\"metadata\\":{\\"name\\":\\"vm-ide-1.170e446c3f890433\\",\\"namespace\\":\\"default\\",\\"uid\\":\\"0b44b6c7-b415-4034-95e5-a476fcec547f\\",\\"resourceVersion\\":\\"612482\\",\\"creationTimestamp\\":\\"2022-08-24T11:29:04Z\\",\\"managedFields\\":[{\\"manager\\":\\"virt-controller\\",\\"operation\\":\\"Update\\",\\"apiVersion\\":\\"v1\\",\\"time\\":\\"2022-08-24T11:29:04Z\\"}]},\\"involvedObject\\":{\\"kind\\":\\"VirtualMachineInstance\\",\\"namespace\\":\\"default\\",\\"name\\":\\"vm-ide-1\\",\\"uid\\":\\"1bd4133f-5aa3-4eda-bd26-3193b255b480\\",\\"apiVersion\\":\\"kubevirt.io/v1\\",\\"resourceVersion\\":\\"612477\\"},\\"reason\\":\\"SuccessfulDelete\\",\\"message\\":\\"Deleted PodDisruptionBudget kubevirt-disruption-budget-hmmgd\\",\\"source\\":{\\"component\\":\\"disruptionbudget-controller\\"},\\"firstTimestamp\\":\\"2022-08-24T11:29:04Z\\",\\"lastTimestamp\\":\\"2022-08-24T11:29:04Z\\",\\"count\\":1,\\"type\\":\\"Normal\\",\\"eventTime\\":null,\\"reportingComponent\\":\\"\\",\\"reportingInstance\\":\\"\\"}
  }",
  "kubernetes":{"pod_name":"harvester-default-event-tailer-0","namespace_name":"cattle-logging-system","pod_id":"d3453153-58c9-456e-b3c3-d91242580df3","labels":{"app.kubernetes.io/instance":"harvester-default-event-tailer","app.kubernetes.io/name":"event-tailer","controller-revision-hash":"harvester-default-event-tailer-747b9d4489","statefulset.kubernetes.io/pod-name":"harvester-default-event-tailer-0"},"annotations":{"cni.projectcalico.org/containerID":"aa72487922ceb4420ebdefb14a81f0d53029b3aec46ed71a8875ef288cde4103","cni.projectcalico.org/podIP":"10.52.0.178/32","cni.projectcalico.org/podIPs":"10.52.0.178/32","k8s.v1.cni.cncf.io/network-status":"[{\\n    \\"name\\": \\"k8s-pod-network\\",\\n    \\"ips\\": [\\n        \\"10.52.0.178\\"\\n    ],\\n    \\"default\\": true,\\n    \\"dns\\": {}\\n}]","k8s.v1.cni.cncf.io/networks-status":"[{\\n    \\"name\\": \\"k8s-pod-network\\",\\n    \\"ips\\": [\\n        \\"10.52.0.178\\"\\n    ],\\n    \\"default\\": true,\\n    \\"dns\\": {}\\n}]","kubernetes.io/psp":"global-unrestricted-psp"},"host":"harv1","container_name":"harvester-default-event-tailer-0","docker_id":"455064de50cc4f66e3dd46c074a1e4e6cfd9139cb74d40f5ba00b4e3e2a7ab2d","container_hash":"docker.io/banzaicloud/eventrouter@sha256:6353d3f961a368d95583758fa05e8f4c0801881c39ed695bd4e8283d373a4262","container_image":"docker.io/banzaicloud/eventrouter:v0.1.0"}
}
事件日誌 Output/ClusterOutput
事件與 Logging 共享 Output/ClusterOutput。
從 Type(類型)下拉式選單中選擇 Logging/Event(日誌記錄/事件)。
事件日誌 Flow/ClusterFlow
與普通 Logging 的 Flow/ClusterFlow 相比,Event 相關的 Flow/ClusterFlow 多了一個值為 event-tailer 的 match 欄位。
當您從 Harvester 儀表板配置時,該欄位會自動添加。
從 Type(類型)下拉式選單中選擇 Event(事件)。
當您從 CLI 配置時,請手動添加該欄位。
範例:
apiVersion: logging.banzaicloud.io/v1beta1
kind: ClusterFlow
metadata:
  name: harvester-event-webhook
  namespace: cattle-logging-system
spec:
  filters:
  - tag_normaliser: {}
  match:
  - select:
      labels:
        app.kubernetes.io/name: event-tailer
  globalOutputRefs:
    - harvester-event-webhook