VM
以下章節包含對 Harvester 虛擬機管理相關問題進行故障排除的有用資訊。
虛擬機啟動按鈕不可見
問題描述
在極少數情況下,Harvester UI 上狀態為 Off 的虛擬機無法使用 Start 按鈕。沒有該按鈕,使用者無法啟動虛擬機。
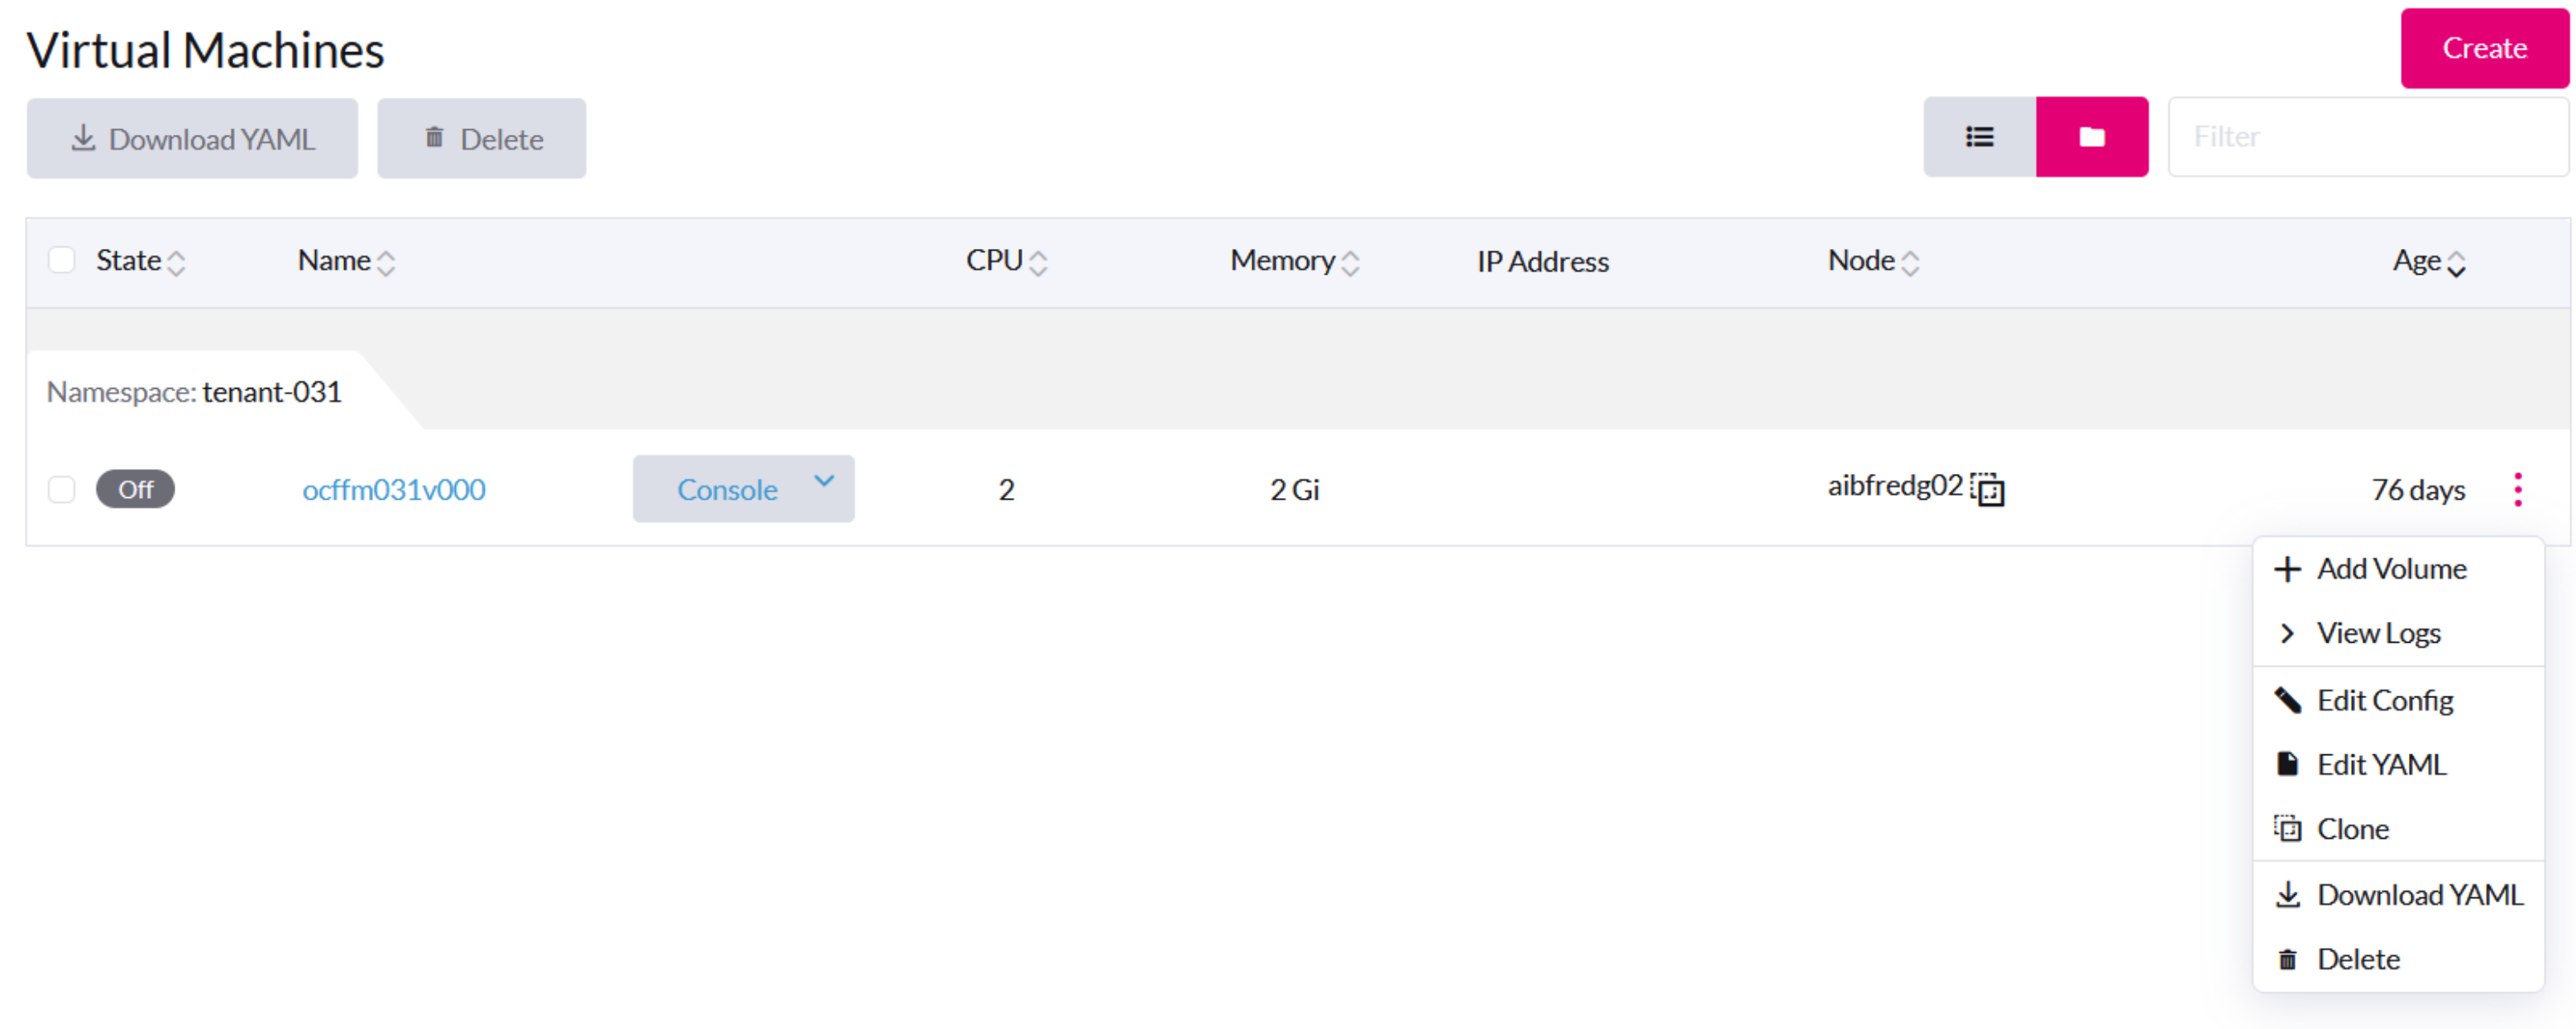
虛擬機一般操作
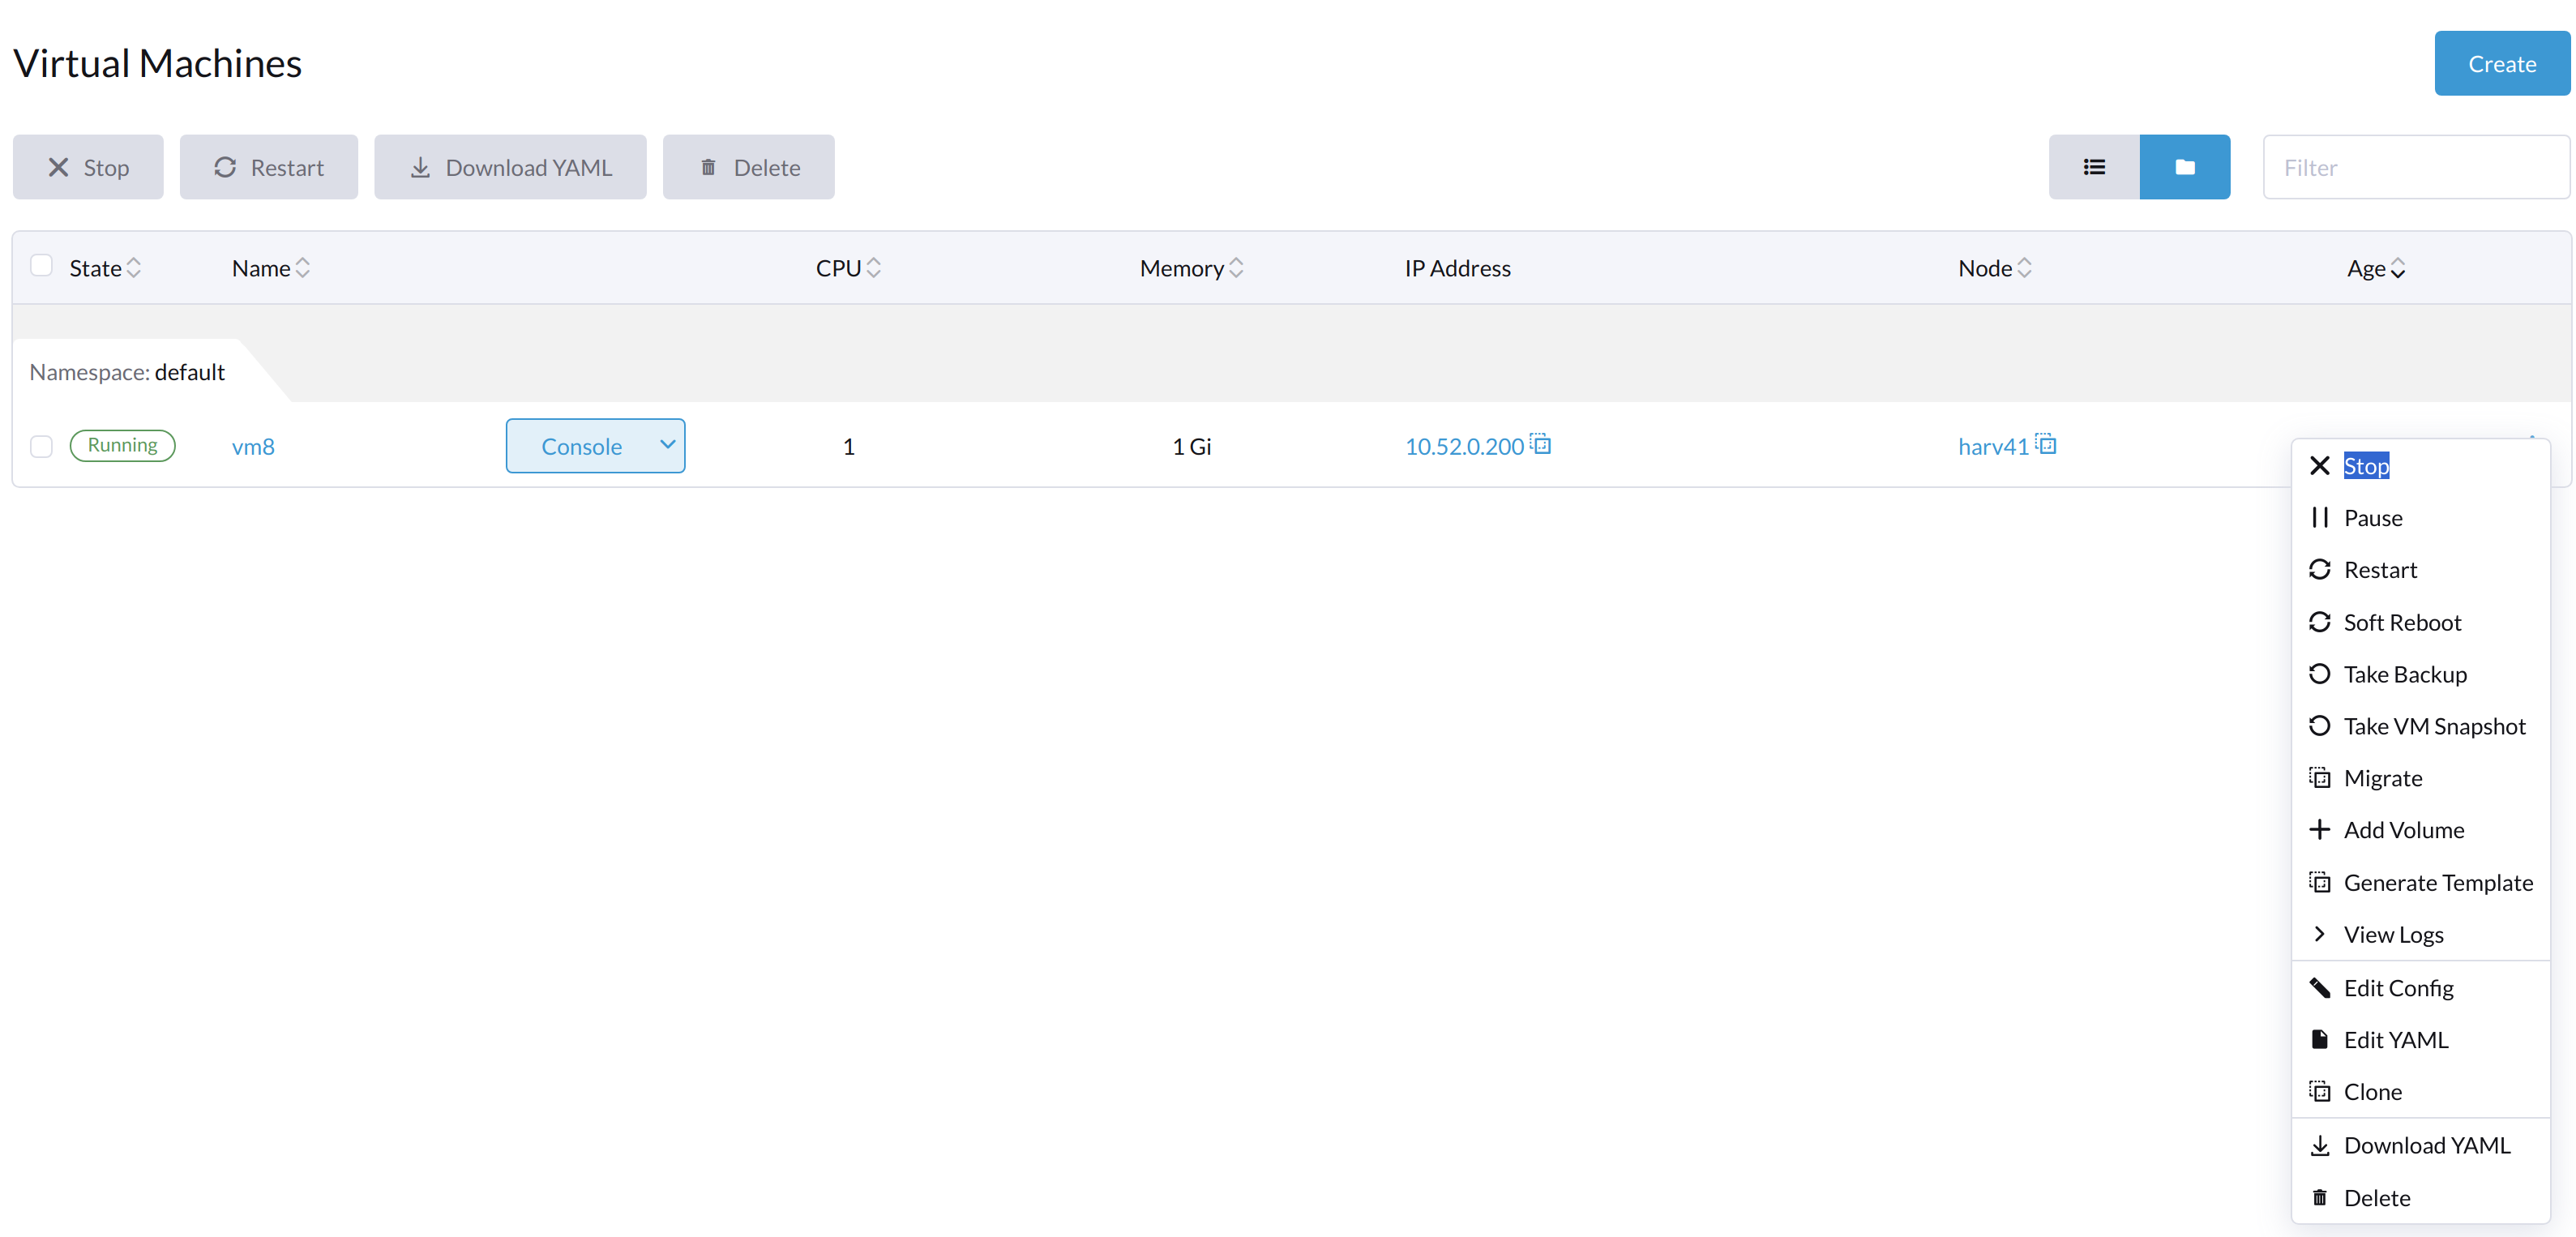
在 Harvester UI 上,虛擬機建立並啟動後會顯示 Stop 按鈕。
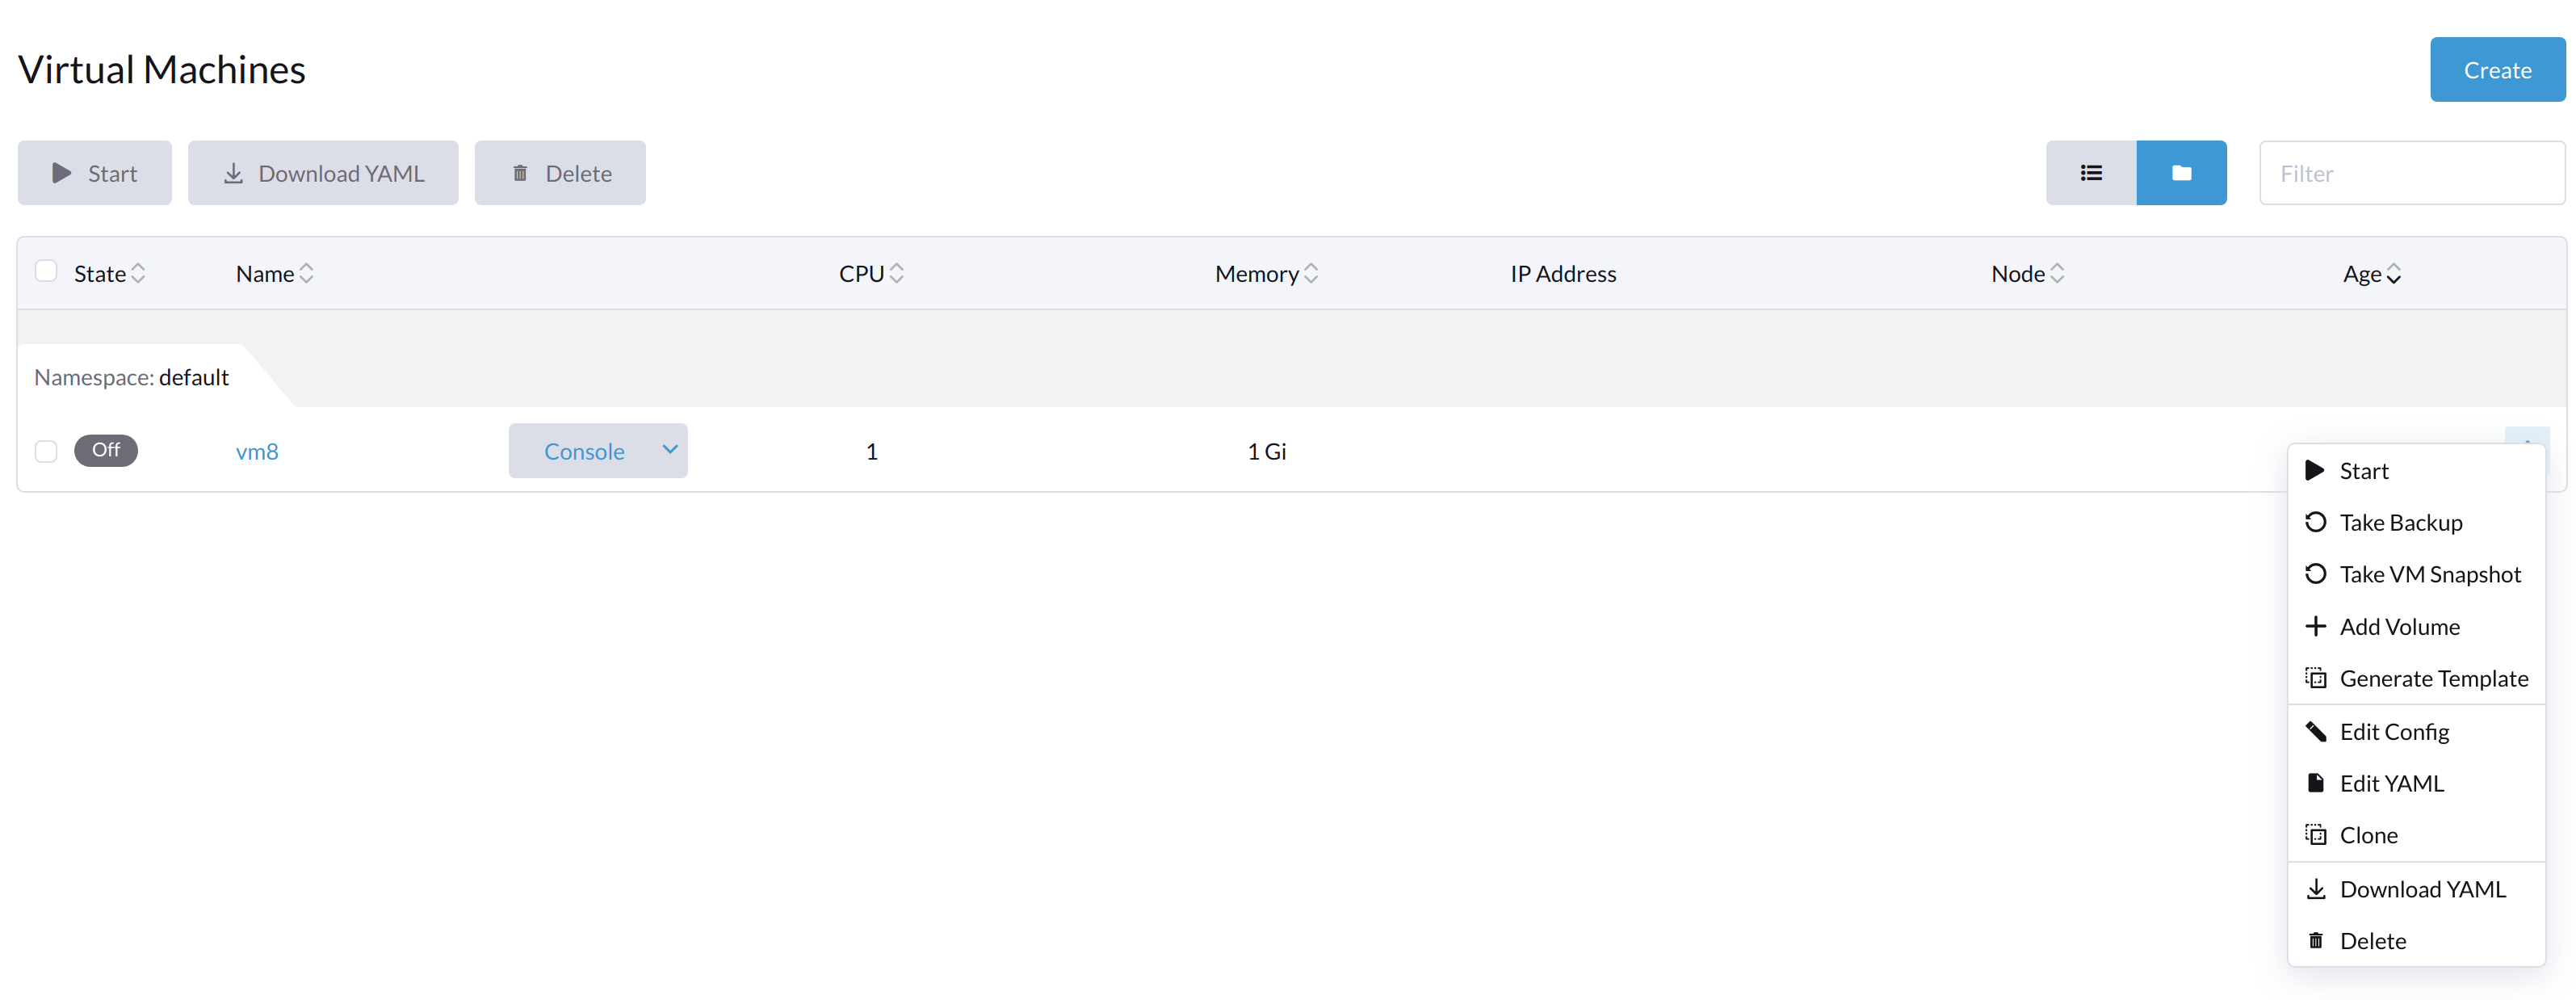
虛擬機停止後會顯示 Start 按鈕。
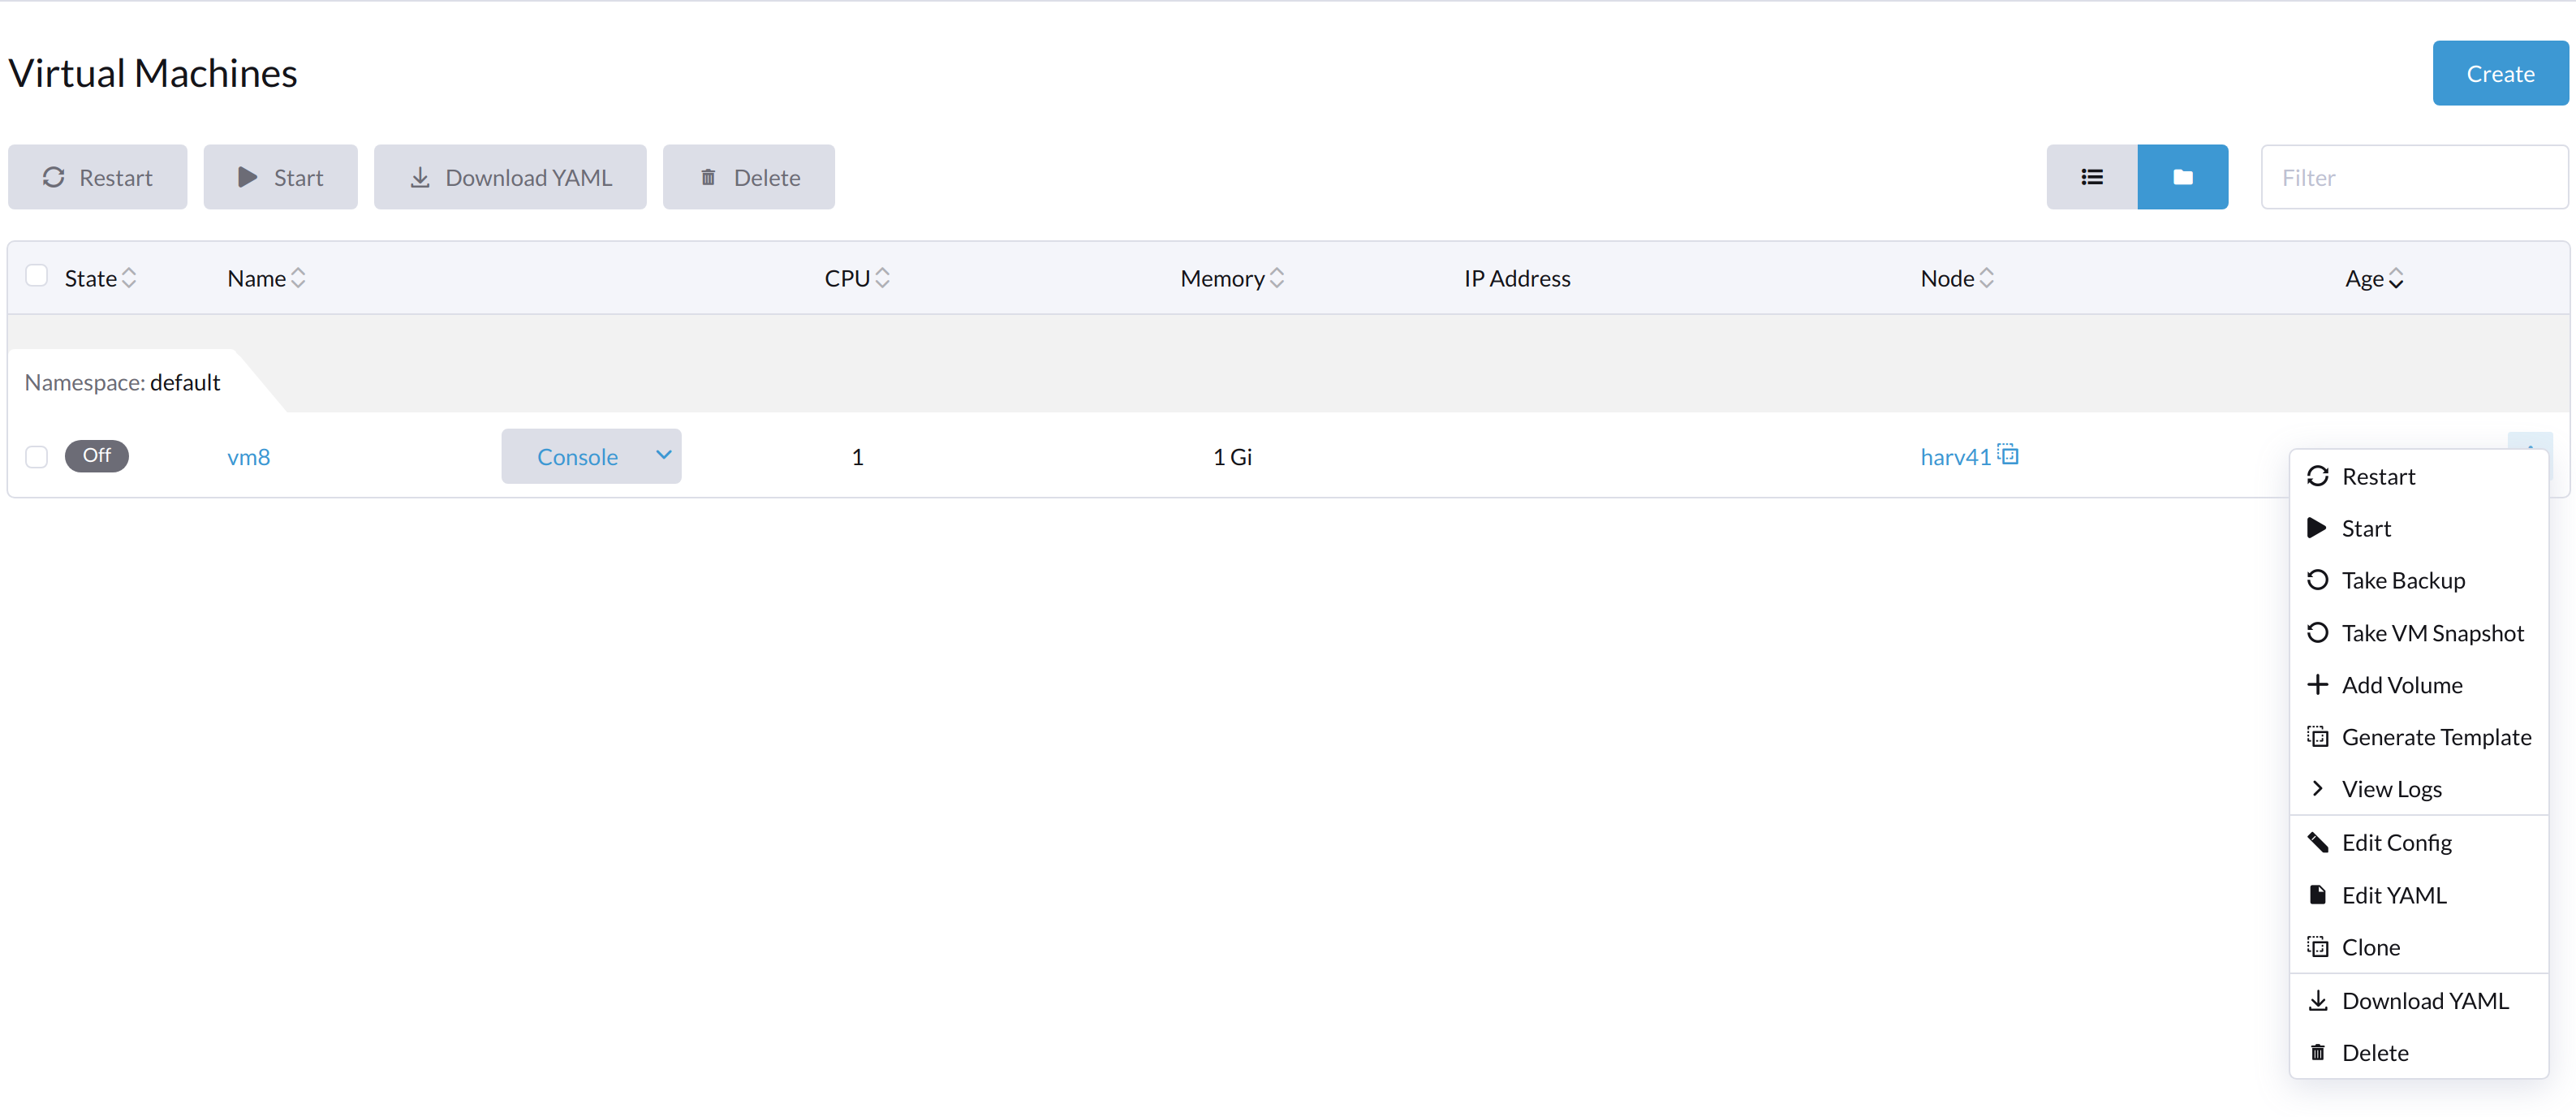
當虛擬機從虛擬機內部關閉電源時,Start 和 Restart 按鈕都會顯示。
一般虛擬機相關物件
執行中的虛擬機
與虛擬機相關的物件 vm、vmi 和 pod 都存在。所有三個物件的狀態都是 Running。
 # kubectl get vm
NAME   AGE     STATUS    READY
vm8    7m25s   Running   True

 # kubectl get vmi
NAME   AGE   PHASE     IP            NODENAME   READY
vm8    78s   Running   10.52.0.199   harv41     True

 # kubectl get pod
NAME                      READY   STATUS    RESTARTS   AGE
virt-launcher-vm8-tl46h   1/1     Running   0          80s
使用 Harvester UI 停止的虛擬機
只有物件 vm 存在,其狀態為 Stopped。vmi 和 pod 都消失了。
 # kubectl get vm
NAME   AGE    STATUS    READY
vm8    123m   Stopped   False

 # kubectl get vmi
No resources found in default namespace.

 # kubectl get pod
No resources found in default namespace.
 #
使用虛擬機關機命令停止的虛擬機
與虛擬機相關的物件 vm、vmi 和 pod 都存在。vm 的狀態是 Stopped,而 pod 的狀態是 Completed。
 # kubectl get vm
NAME   AGE    STATUS    READY
vm8    134m   Stopped   False

 # kubectl get vmi
NAME   AGE     PHASE       IP            NODENAME   READY
vm8    2m49s   Succeeded   10.52.0.199   harv41     False

 # kubectl get pod
NAME                      READY   STATUS      RESTARTS   AGE
virt-launcher-vm8-tl46h   0/1     Completed   0          2m54s
問題分析
當問題發生時,物件 vm、vmi 和 pod 都存在。物件的狀態類似於使用虛擬機關機命令停止的虛擬機。
範例:
虛擬機 ocffm031v000 未就緒(status: "False"),因為 virt-launcher Pod 正在終止(reason: "PodTerminating")。
- apiVersion: kubevirt.io/v1
  kind: VirtualMachine
...
  status:
    conditions:
    - lastProbeTime: "2023-07-20T08:37:37Z"
      lastTransitionTime: "2023-07-20T08:37:37Z"
      message: virt-launcher pod is terminating
      reason: PodTerminating
      status: "False"
      type: Ready
同樣地,VMI(虛擬機實例)ocffm031v000 未就緒(status: "False"),因為 virt-launcher Pod 正在終止(reason: "PodTerminating")。
- apiVersion: kubevirt.io/v1
  kind: VirtualMachineInstance
...
    name: ocffm031v000
...
  status:
    activePods:
      ec36a1eb-84a5-4421-b57b-2c14c1975018: aibfredg02
    conditions:
    - lastProbeTime: "2023-07-20T08:37:37Z"
      lastTransitionTime: "2023-07-20T08:37:37Z"
      message: virt-launcher pod is terminating
      reason: PodTerminating
      status: "False"
      type: Ready
另一方面,Pod virt-launcher-ocffm031v000-rrkss 未就緒(status: "False"),因為 Pod 已運行完成(reason: "PodCompleted")。
底層容器 0d7a0f64f91438cb78f026853e6bebf502df1bdeb64878d351fa5756edc98deb 已終止,exitCode 為 0。
- apiVersion: v1
  kind: Pod
...
    name: virt-launcher-ocffm031v000-rrkss
...
    ownerReferences:
    - apiVersion: kubevirt.io/v1
...
      kind: VirtualMachineInstance
      name: ocffm031v000
      uid: 8d2cf524-7e73-4713-86f7-89e7399f25db
    uid: ec36a1eb-84a5-4421-b57b-2c14c1975018
...
  status:
    conditions:
    - lastProbeTime: "2023-07-18T13:48:56Z"
      lastTransitionTime: "2023-07-18T13:48:56Z"
      message: the virtual machine is not paused
      reason: NotPaused
      status: "True"
      type: kubevirt.io/virtual-machine-unpaused
    - lastProbeTime: "null"
      lastTransitionTime: "2023-07-18T13:48:55Z"
      reason: PodCompleted
      status: "True"
      type: Initialized
    - lastProbeTime: "null"
      lastTransitionTime: "2023-07-20T08:38:56Z"
      reason: PodCompleted
      status: "False"
      type: Ready
    - lastProbeTime: "null"
      lastTransitionTime: "2023-07-20T08:38:56Z"
      reason: PodCompleted
      status: "False"
      type: ContainersReady
...
    containerStatuses:
    - containerID: containerd://0d7a0f64f91438cb78f026853e6bebf502df1bdeb64878d351fa5756edc98deb
      image: registry.suse.com/suse/sles/15.4/virt-launcher:0.54.0-150400.3.3.2
      imageID: sha256:43bb08efdabb90913534b70ec7868a2126fc128887fb5c3c1b505ee6644453a2
      lastState: {}
      name: compute
      ready: false
      restartCount: 0
      started: false
      state:
        terminated:
          containerID: containerd://0d7a0f64f91438cb78f026853e6bebf502df1bdeb64878d351fa5756edc98deb
          exitCode: 0
          finishedAt: "2023-07-20T08:38:55Z"
          reason: Completed
          startedAt: "2023-07-18T13:50:17Z"
一個關鍵的區別是 Stop 和 Start 操作出現在 vm 的 stateChangeRequests 屬性中。
  status:
    conditions:
...
    printableStatus: Stopped
    stateChangeRequests:
    - action: Stop
      uid: 8d2cf524-7e73-4713-86f7-89e7399f25db
    - action: Start
根本原因
此問題的根本原因正在調查中。
值得注意的是,原始碼檢查 vm 的狀態並假設物件正在啟動。沒有將 Start 和 Restart 操作新增到物件中。
func (vf *vmformatter) canStart(vm *kubevirtv1.VirtualMachine, vmi *kubevirtv1.VirtualMachineInstance) bool {
  if vf.isVMStarting(vm) {
    return false
  }
..
}

func (vf *vmformatter) canRestart(vm *kubevirtv1.VirtualMachine, vmi *kubevirtv1.VirtualMachineInstance) bool {
  if vf.isVMStarting(vm) {
    return false
  }
...
}

func (vf *vmformatter) isVMStarting(vm *kubevirtv1.VirtualMachine) bool {
  for _, req := range vm.Status.StateChangeRequests {
    if req.Action == kubevirtv1.StartRequest {
      return true
    }
  }
  return false
}
解決方法
要解決此問題,您可以使用命令 kubectl delete pod virt-launcher-ocffm031v000-rrkss -n namespace --force 強制刪除 Pod。
Pod 成功刪除後,Harvester UI 上會再次顯示 Start 按鈕。
相關問題
https://github.com/harvester/harvester/issues/4659
虛擬機卡在啟動狀態並顯示錯誤訊息 not a device node
受影響的版本:v1.3.0
問題描述
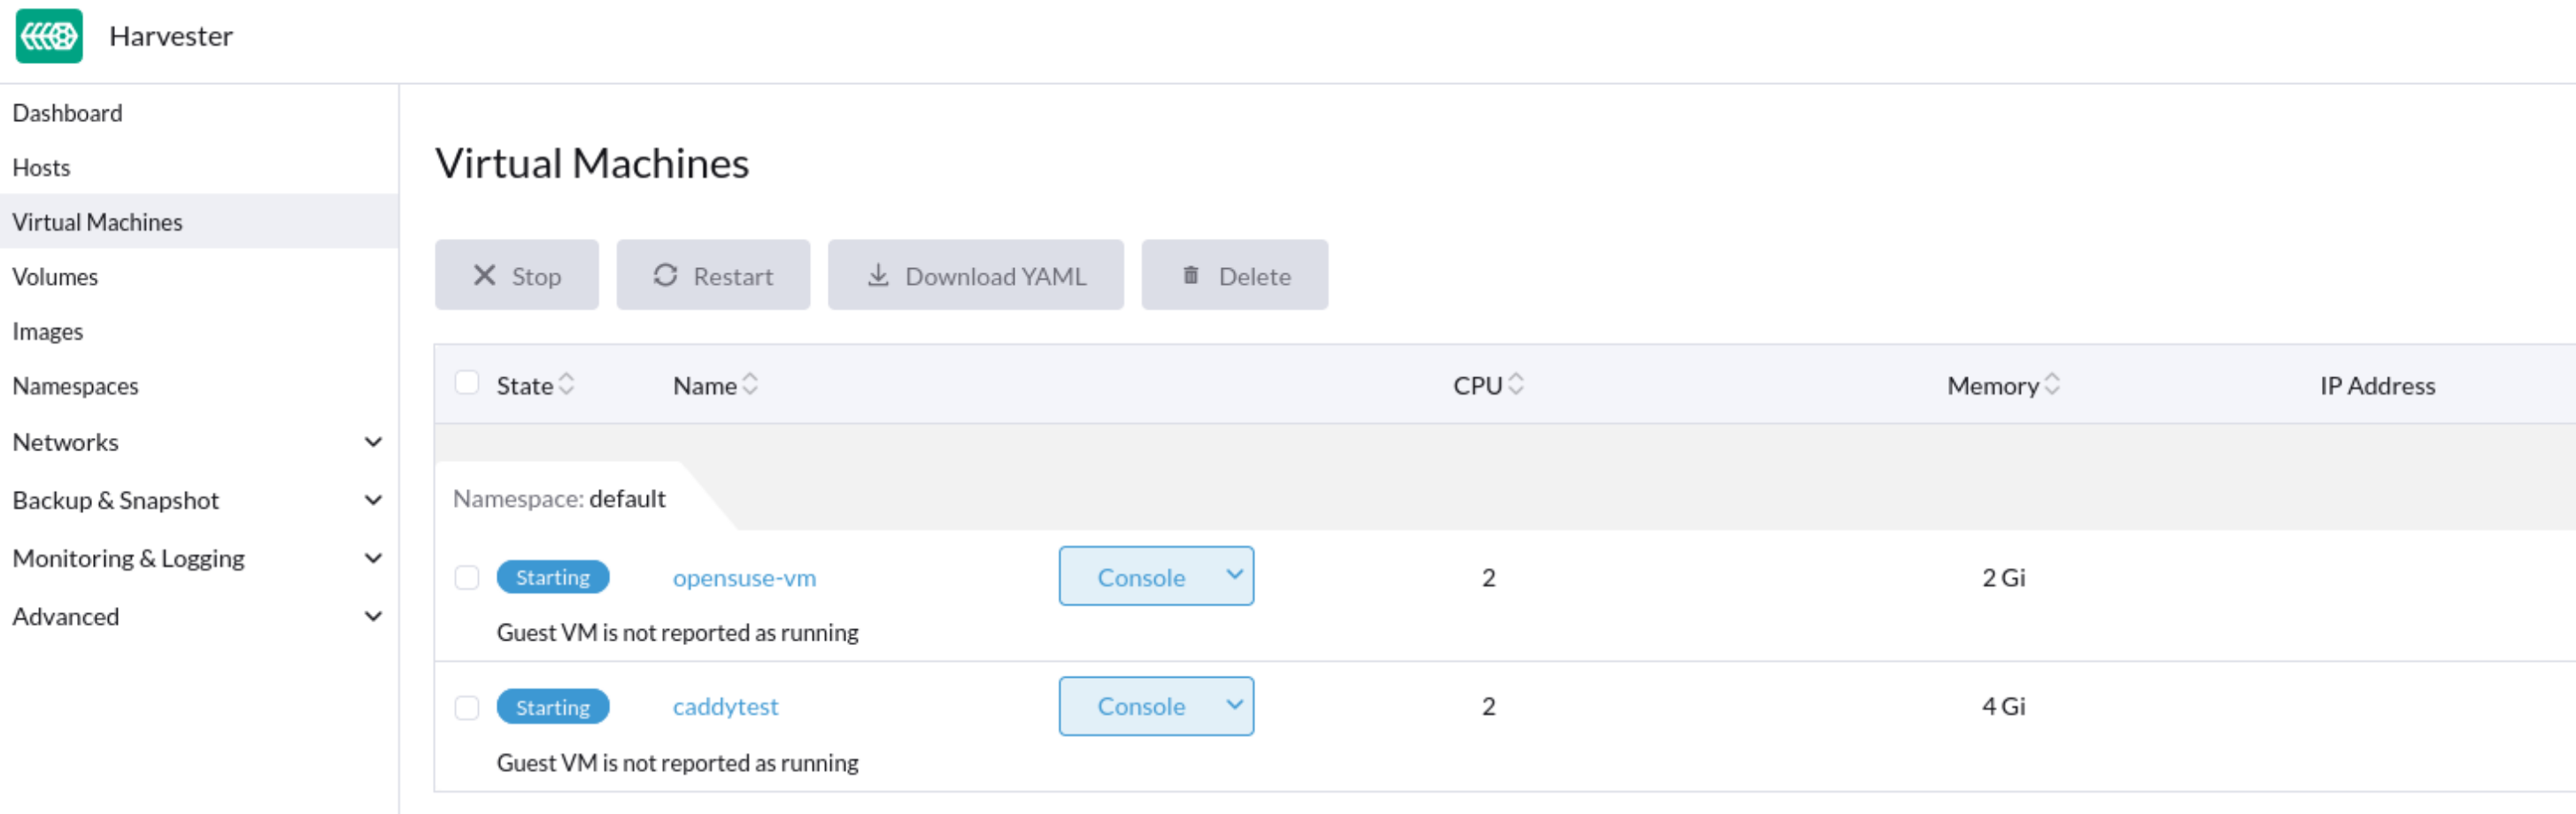
重新啟動叢集或某些節點後,某些虛擬機可能無法啟動,然後變得無回應。在 Harvester UI 的 Dashboard 畫面上,受影響虛擬機的狀態卡在 Starting。
問題分析
與受影響虛擬機相關的 Pod 狀態為 CreateContainerError。
$ kubectl get pods
NAME                      READY   STATUS                 RESTARTS   AGE
virt-launcher-vm1-w9bqs   0/2     CreateContainerError   0          9m39s
可以在以下位置找到短語 failed to generate spec: not a device node:
$kubectl get pods -oyaml
apiVersion: v1
items:
  apiVersion: v1
  kind: Pod
  metadata:
...
    containerStatuses:
    - image: registry.suse.com/suse/sles/15.5/virt-launcher:1.1.0-150500.8.6.1
      imageID: ""
      lastState: {}
      name: compute
      ready: false
      restartCount: 0
      started: false
      state:
        waiting:
          message: 'failed to generate container "50f0ec402f6e266870eafb06611850a5a03b2a0a86fdd6e562959719ccc003b5"
            spec: failed to generate spec: not a device node'
          reason: CreateContainerError
kubelet.log 檔案:
file path: /var/lib/rancher/rke2/agent/logs/kubelet.log

E0205 20:44:31.683371    2837 pod_workers.go:1294] "Error syncing pod, skipping" err="failed to \"StartContainer\" for \"compute\" with CreateContainerError: \"failed t
o generate container \\\"255d42ec2e01d45b4e2480d538ecc21865cf461dc7056bc159a80ee68c411349\\\" spec: failed to generate spec: not a device node\"" pod="default/virt-laun
cher-caddytest-9tjzj" podUID=d512bf3e-f215-4128-960a-0658f7e63c7c
containerd.log 檔案:
file path: /var/lib/rancher/rke2/agent/containerd/containerd.log

time="2024-02-21T11:24:00.140298800Z" level=error msg="CreateContainer within sandbox \"850958f388e63f14a683380b3c52e57db35f21c059c0d93666f4fdaafe337e56\" for &ContainerMetadata{Name:compute,Attempt:0,} failed" error="failed to generate container \"5ddad240be2731d5ea5210565729cca20e20694e364e72ba14b58127e231bc79\" spec: failed to generate spec: not a device node"
在向 containerd 新增除錯資訊後,它識別出錯誤訊息 not a device node 是針對檔案 pvc-3c1b28fb-*。
time="2024-02-22T15:15:08.557487376Z" level=error msg="CreateContainer within sandbox \"d23af3219cb27228623cf8168ec27e64e836ed44f2b2f9cf784f0529a7f92e1e\" for &ContainerMetadata{Name:compute,Attempt:0,} failed" error="failed to generate container \"e4ed94fb5e9145e8716bcb87aae448300799f345197d52a617918d634d9ca3e1\" spec: failed to generate spec: get device path: /var/lib/kubelet/plugins/kubernetes.io/csi/volumeDevices/publish/pvc-3c1b28fb-683e-4bf5-9869-c9107a0f1732/20291c6b-62c3-4456-be8a-fbeac118ec19 containerPath: /dev/disk-0 error: not a device node"
這是一個 CSI 相關的檔案,但它是一個空檔案而不是預期的裝置檔案。然後 containerd 拒絕了 CreateContainer 請求。
$ ls /var/lib/kubelet/plugins/kubernetes.io/csi/volumeDevices/publish/pvc-3c1b28fb-683e-4bf5-9869-c9107a0f1732/ -alth
total 8.0K
drwxr-x--- 2 root root 4.0K Feb 22 15:10 .
-rw-r--r-- 1 root root    0 Feb 22 14:28 aa851da3-cee1-45be-a585-26ae766c16ca
-rw-r--r-- 1 root root    0 Feb 22 14:07 20291c6b-62c3-4456-be8a-fbeac118ec19
drwxr-x--- 4 root root 4.0K Feb 22 14:06 ..
-rw-r--r-- 1 root root    0 Feb 21 15:48 4333c9fd-c2c8-4da2-9b5a-1a310f80d9fd
-rw-r--r-- 1 root root    0 Feb 21 09:18 becc0687-b6f5-433e-bfb7-756b00deb61b

$file /var/lib/kubelet/plugins/kubernetes.io/csi/volumeDevices/publish/pvc-3c1b28fb-683e-4bf5-9869-c9107a0f1732/20291c6b-62c3-4456-be8a-fbeac118ec19
: empty
上面列出的輸出與以下範例形成直接對比,後者顯示了執行中虛擬機的預期裝置檔案。
$ ls  /var/lib/kubelet/plugins/kubernetes.io/csi/volumeDevices/publish/pvc-732f8496-103b-4a08-83af-8325e1c314b7/ -alth
total 8.0K
drwxr-x--- 2 root root  4.0K Feb 21 10:53 .
drwxr-x--- 4 root root  4.0K Feb 21 10:53 ..
brw-rw---- 1 root root 8, 16 Feb 21 10:53 4883af80-c202-4529-a2c6-4e7f15fe5a9b
根本原因
叢集或特定節點重新啟動後,kubelet 為新 Pod 呼叫 NodePublishVolume,而未先呼叫 NodeStageVolume。此外,Longhorn CSI 外掛程式將暫存目標路徑(先前由已刪除的 Pod 使用)的常規檔案綁定掛載到目標路徑,並認為操作成功。
解決方法
叢集級別操作:
-
找到受影響虛擬機的支援 Pod 和相關的 Longhorn 儲存區。
$ kubectl get pods
NAME                      READY   STATUS                 RESTARTS   AGE
virt-launcher-vm1-nxfm4   0/2     CreateContainerError   0          7m11s

$ kubectl get pvc -A
NAMESPACE                  NAME                       STATUS   VOLUME                                     CAPACITY   ACCESS MODES   STORAGECLASS           AGE
default vm1-disk-0-9gc6h Bound pvc-f1798969-5b72-4d76-9f0e-64854af7b59c 1Gi RWX longhorn-image-fxsqr 7d22h -
從 Harvester UI 停止受影響的虛擬機。
虛擬機可能會卡在
Stopping,繼續下一步。 -
強制刪除支援 Pod。
$ kubectl delete pod virt-launcher-vm1-nxfm4 --force
Warning: Immediate deletion does not wait for confirmation that the running resource has been terminated. The resource may continue to run on the cluster indefinitely.
pod "virt-launcher-vm1-nxfm4" force deleted
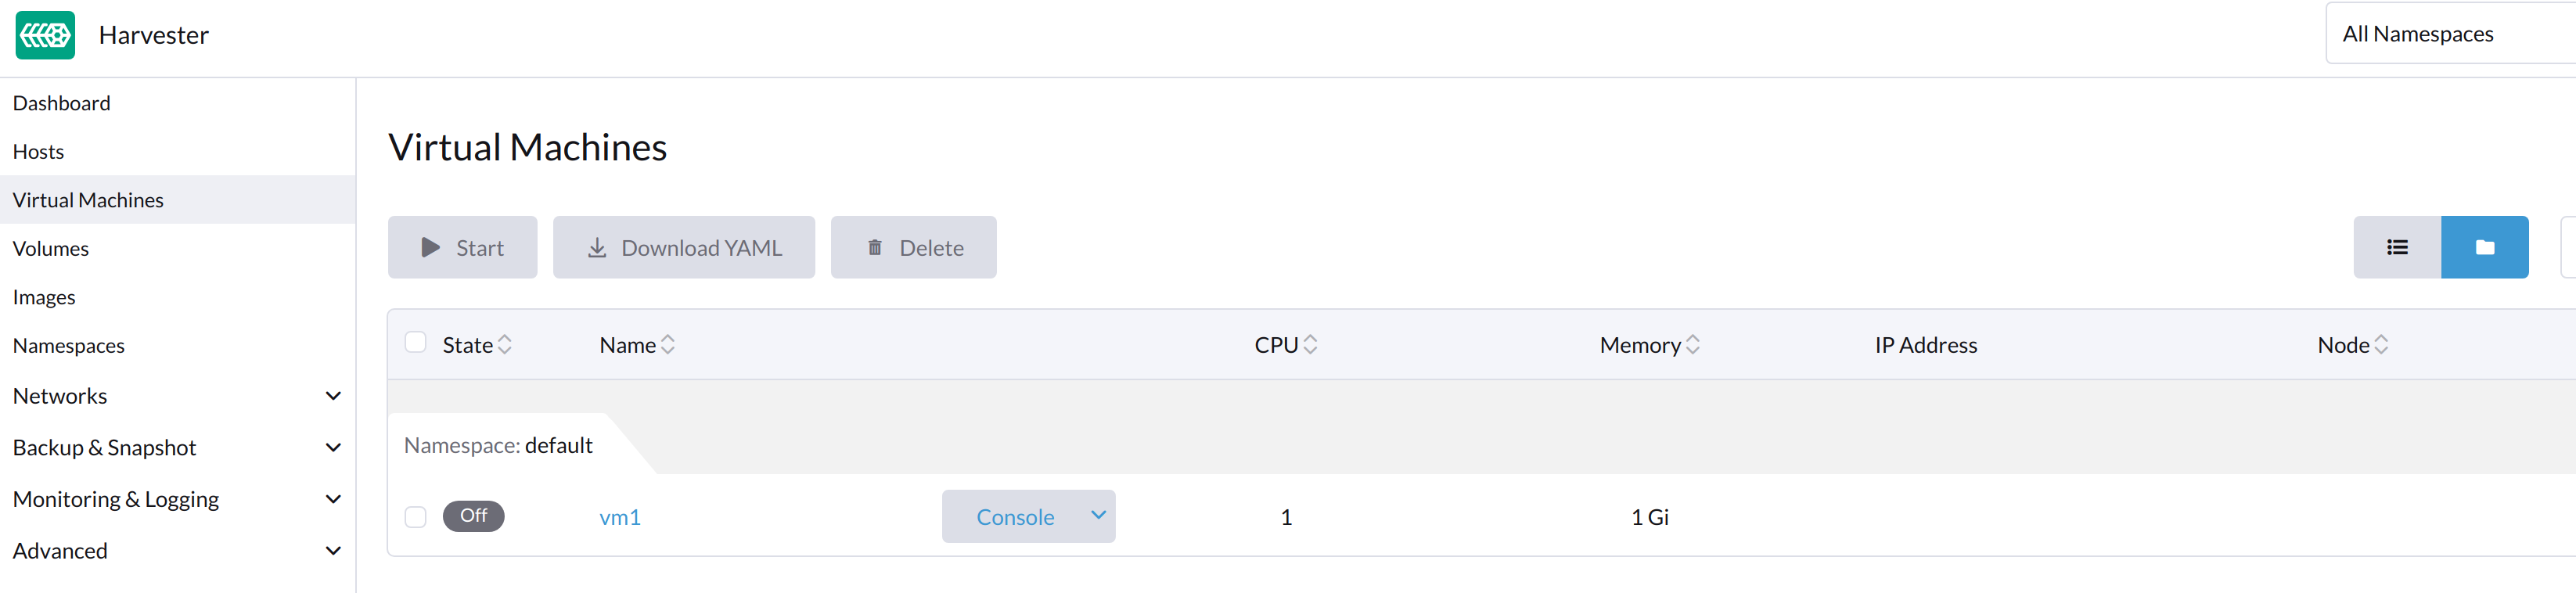
虛擬機現在已關閉。
節點級別操作,逐個節點:
-
隔離節點。
-
在此節點中卸載所有受影響的 Longhorn 儲存區。
您需要 SSH 到此節點並執行
sudo -i umount path命令。$ umount /var/lib/kubelet/plugins/kubernetes.io/csi/volumeDevices/pvc-f1798969-5b72-4d76-9f0e-64854af7b59c/dev/*
umount: /var/lib/kubelet/plugins/kubernetes.io/csi/volumeDevices/pvc-f1798969-5b72-4d76-9f0e-64854af7b59c/dev/4b2ab666-27bd-4e3c-a218-fb3d48a72e69: not mounted.
umount: /var/lib/kubelet/plugins/kubernetes.io/csi/volumeDevices/pvc-f1798969-5b72-4d76-9f0e-64854af7b59c/dev/6aaf2bbe-f688-4dcd-855a-f9e2afa18862: not mounted.
umount: /var/lib/kubelet/plugins/kubernetes.io/csi/volumeDevices/pvc-f1798969-5b72-4d76-9f0e-64854af7b59c/dev/91488f09-ff22-45f4-afc0-ca97f67555e7: not mounted.
umount: /var/lib/kubelet/plugins/kubernetes.io/csi/volumeDevices/pvc-f1798969-5b72-4d76-9f0e-64854af7b59c/dev/bb4d0a15-737d-41c0-946c-85f4a56f072f: not mounted.
umount: /var/lib/kubelet/plugins/kubernetes.io/csi/volumeDevices/pvc-f1798969-5b72-4d76-9f0e-64854af7b59c/dev/d2a54e32-4edc-4ad8-a748-f7ef7a2cacab: not mounted. -
取消隔離此節點。
-
從 Harvester UI 啟動受影響的虛擬機。
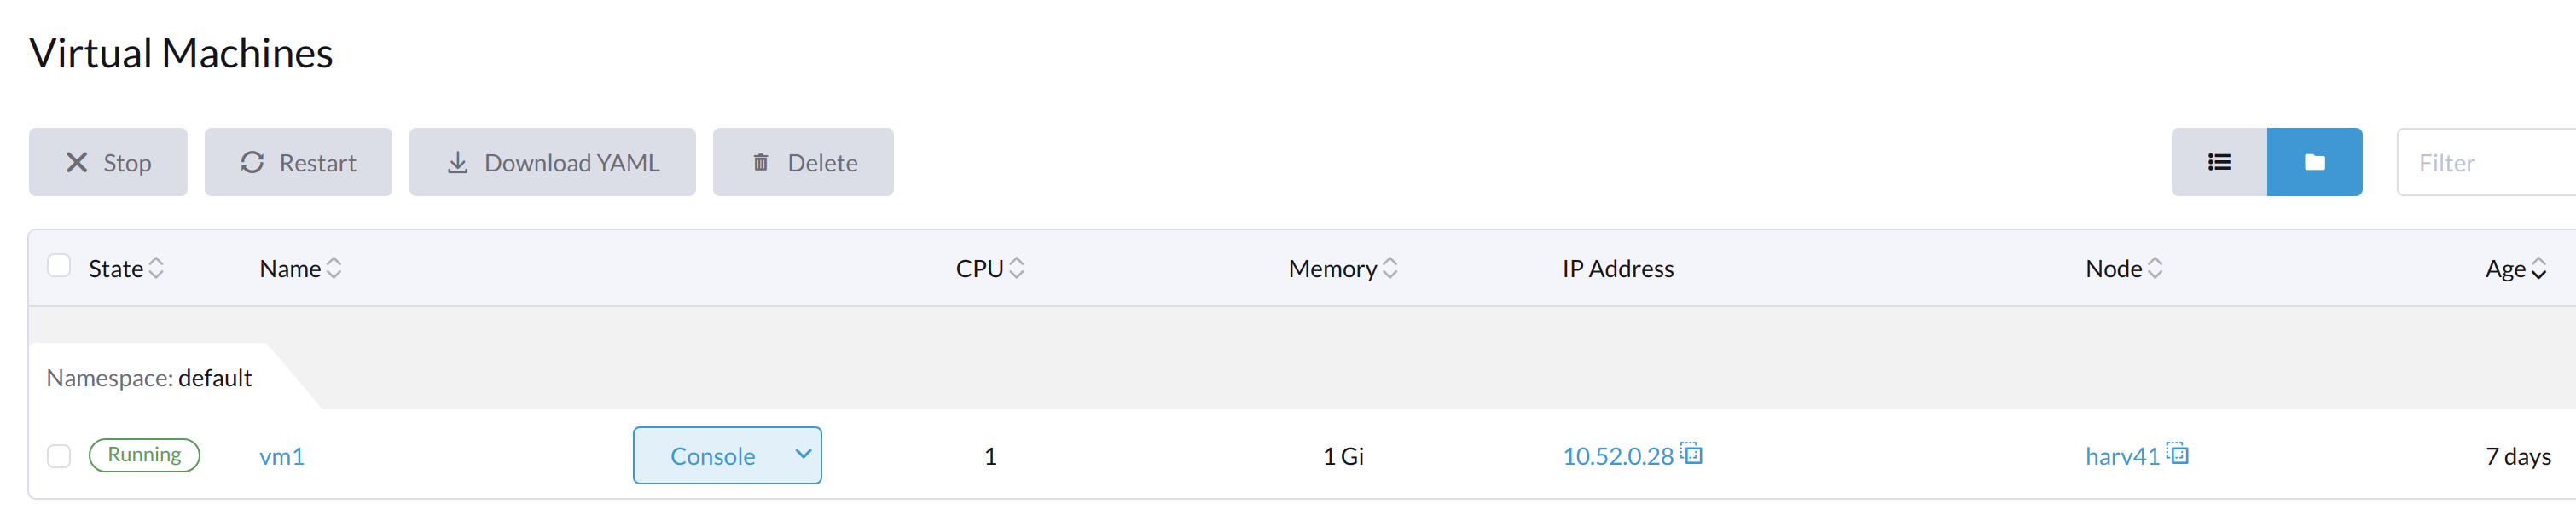
等待一段時間,虛擬機將成功執行。
新產生的 CSI 檔案是預期的裝置檔案。
$ ls /var/lib/kubelet/plugins/kubernetes.io/csi/volumeDevices/publish/pvc-f1798969-5b72-4d76-9f0e-64854af7b59c/ -alth
...
brw-rw---- 1 root root 8, 64 Mar  6 11:47 7beb531d-a781-4775-ba5e-8773773d77f1
相關問題
https://github.com/harvester/harvester/issues/5109
https://github.com/longhorn/longhorn/issues/8009
虛擬機 IP 位址未顯示
未安裝 qemu-guest-agent 套件
描述
Harvester UI 上的 Virtual Machines 畫面未顯示新建立或匯入的虛擬機的 IP 位址。
分析
此問題通常發生在虛擬機上未安裝 qemu-guest-agent 套件時。要確定這是否為根本原因,請檢查 VirtualMachineInstance 物件的狀態。
$ kubectl get vmi -n <NAMESPACE> <NAME> -ojsonpath='{.status.interfaces[0].infoSource}'
未安裝 qemu-guest-agent 套件時,輸出不包含字串 guest-agent。
解決方法
您可以透過編輯虛擬機配置來安裝 QEMU 訪客代理程式。
-
在 Harvester UI 上,前往 Virtual Machines。
-
找到受影響的虛擬機,然後選擇 ⋮ > Edit Config。
-
在 Advanced Options 標籤上的 Cloud Config 下,選擇 Install guest agent。
-
點擊 Save。
但是,cloud-init 僅執行一次(首次啟動虛擬機時)。要套用新的 Cloud Config 設定,您必須刪除虛擬機中的 cloud-init 目錄。
$ sudo rm -rf /var/lib/cloud/*
刪除目錄後,您必須重新啟動虛擬機,以便再次執行 cloud-init 並安裝 qemu-guest-agent 套件。
相關問題
https://github.com/harvester/harvester/issues/6644
virt-launcher Pod 和訪客作業系統之間的 IPv6 競爭條件
描述
每當 virt-launcher Pod 的網路介面取得 IPv6 link-local 位址時,Harvester UI 不會顯示虛擬機的 IP 位址。
分析
QEMU 訪客代理程式負責向虛擬機實例報告有關訪客作業系統的資訊,包括介面詳細資訊,以便在 Harvester UI 上顯示。當虛擬機的 Pod 介面取得 IPv6 link-local 位址並在 QEMU 訪客代理程式提供自己的資訊之前將其報告給虛擬機實例時,就會發生此問題。一旦發生這種情況,由於 KubeVirt 中的錯誤,來自 QEMU 訪客代理程式的 IPv4 位址永遠不會被報告。
您可以使用以下步驟檢查 Pod 介面和虛擬機實例的 IP 位址:
- 檢索虛擬機實例的 IP 位址。
$ kubectl get vmi -n <NAMESPACE> <NAME> -ojsonpath='{.status.interfaces[0].ipAddress}'
輸出僅顯示 IPv6 link-local 位址。
- 檢索 Pod 介面的 IP 位址。
$ kubectl exec -it -n <namespace> <pod-name> -- /bin/bash -c "ip a show label pod\*"
輸出與虛擬機實例的 IPv6 位址相符。
要檢索分配的 IPv4 位址,請開啟虛擬機的串列控制台並在訪客作業系統內執行 ip a。
此問題通常不會影響虛擬機的操作和執行時間。您仍然可以使用其網路介面的 IPv4 位址透過 SSH 存取虛擬機。
在某些情況下,此問題可能會影響 Rancher 整合,導致訪客叢集中節點的佈建和加入逾時。
解決方法
解決方法是在 Harvester 的核心參數中停用 IPv6。
在上述範例中,您必須新增 ipv6.disable=1 並重新啟動節點以防止虛擬機 Pod 介面取得 IPv6 link-local 位址。
相關問題
虛擬機 IP 位址間歇性地未顯示
描述
新虛擬機的 IP 位址在 Harvester UI 上間歇性地消失和重新出現。
分析
QEMU 訪客代理程式負責向虛擬機實例報告有關訪客作業系統的資訊,包括介面詳細資訊,以便在 Harvester UI 上顯示。當虛擬機實例使用包含空網路介面的網域資料更新時,就會發生此問題,這是由上游 KubeVirt 問題引起的。
在 Alma Linux 9 和 Rocky Linux 9 中更常觀察到此行為,其中 QEMU 訪客代理程式頻繁地將檔案系統資訊更新到虛擬機實例。
要檢查您的環境中是否存在此問題,請在不同時間執行以下命令:
$ kubectl get vmi -n <NAMESPACE> <NAME> -ojsonpath='{.status.interfaces[0].ipAddress}'
執行命令時,ipAddress 欄位可能為空。
要檢索分配的 IPv4 位址,請開啟虛擬機的串列控制台並在訪客作業系統內執行 ip a。
此問題通常不會影響虛擬機的操作和執行時間。您仍然可以使用其網路介面的 IPv4 位址透過 SSH 存取虛擬機。
解決方法
雖然此問題沒有直接的解決方法,但上游修復已最佳化程式碼以減少來自 QEMU 訪客代理程式的不必要更新。此增強功能可能會防止問題發生。
相關問題
無法排程的虛擬機
由於不滿足親和性規則,虛擬機的狀態為 Unschedulable。

VirtualMachine 物件包含類似以下的親和性規則:
apiVersion: kubevirt.io/v1
kind: VirtualMachine
metadata:
  name: vm100
  namespace: default
    spec:
      affinity:
        nodeAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            nodeSelectorTerms:
              - matchExpressions:
                  - key: network.harvesterhci.io/cn2
                    operator: In
                    values:
                      - 'true'
Pod 狀態為 Pending,錯誤訊息指示沒有節點滿足親和性規則的條件。
$ kubectl get pods
NAME                        READY   STATUS    RESTARTS   AGE
virt-launcher-vm100-f4nh4   0/2     Pending   0          5m12s

$ kubectl get pods virt-launcher-vm100-f4nh4 -oyaml
apiVersion: v1
kind: Pod
metadata:
  name: virt-launcher-vm100-f4nh4
  namespace: default
spec:
  affinity:
    nodeAffinity:
      requiredDuringSchedulingIgnoredDuringExecution:
        nodeSelectorTerms:
        - matchExpressions:
          - key: network.harvesterhci.io/cn2
            operator: In
            values:
            - "true"

...
status:
  conditions:
  - lastProbeTime: null
    lastTransitionTime: "2025-07-28T16:21:56Z"
    message: '0/2 nodes are available: 1 node(s) didn''t match Pod''s node affinity/selector,
      1 node(s) had untolerated taint {node.kubernetes.io/unreachable: }. preemption:
      0/2 nodes are available: 2 Preemption is not helpful for scheduling.'
    reason: Unschedulable
    status: "False"
    type: PodScheduled
...
根本原因
Harvester 可能會根據虛擬機的定義自動套用親和性規則。在上述範例中,虛擬機 vm100 附加到叢集網路 cn2,Harvester 套用親和性規則 network.harvesterhci.io/cn2。但是,沒有節點滿足規則的條件,因此無法排程虛擬機。
解決方案
確保有活躍的節點成功設定了叢集網路 cn2,然後這些節點會標記為 network.harvesterhci.io/cn2,最後擱置的 Pod 可以排程到它們。
透過 Cloud Config YAML 意外修改虛擬機範本
當您使用範本建立虛擬機,然後使用 Edit as YAML 功能修改該虛擬機的使用者資料時,一旦您儲存變更,來源範本可能會被意外修改。
發生此問題是因為系統未正確解除配置繼承的關聯。由於新配置仍與來源範本連結,儲存變更會自動覆寫範本的資料。
建立虛擬機時避免使用 Edit as YAML 功能,特別是在使用範本時。而是使用 Virtual Machine: Create 畫面上可用的專用欄位和選項。
要減輕此問題,請執行以下步驟:
-
識別受影響虛擬機的名稱和命名空間。
-
識別與受影響虛擬機關聯的 Cloud Config 密鑰。
# 取得連結到虛擬機 cloudInitNoCloud volume source 的當前 Secret 名稱:
VM_NAME=<VM_NAME>
VM_NAMESPACE=<VM_NAMESPACE>

SECRET=$(kubectl get vm $VM_NAME -n $VM_NAMESPACE -o jsonpath='{.spec.template.spec.volumes[?(@.cloudInitNoCloud)].cloudInitNoCloud.secretRef.name}')
SECRET_NAMESPACE=$(kubectl get secret -A | grep $SECRET  | awk '{print $1}')
echo "Current Secret: $SECRET_NAMESPACE -> $SECRET" -
建立密鑰的獨立副本。
匯出當前密鑰,移除識別中繼資料,分配唯一名稱,然後套用密鑰。
# 為密鑰定義一個新的唯一名稱
NEW_SECRET="$VM_NAME-$(date +%s)"

# 匯出、清理、重新命名並建立新的 Secret
kubectl get secret $SECRET -n $SECRET_NAMESPACE -o json | \
  jq 'del(.metadata.creationTimestamp, .metadata.resourceVersion, .metadata.uid, .metadata.ownerReferences, .metadata.annotations["kubectl.kubernetes.io/last-applied-configuration"], .metadata.selfLink)' | \
  jq '.metadata.name = "'"$NEW_SECRET"'"' | \
  jq '.metadata.namespace = "'"$VM_NAMESPACE"'"' | \
kubectl apply -n $VM_NAMESPACE -f - -
更新虛擬機配置以使用新密鑰。
將虛擬機的
cloudInitNoCloudvolume source 指向新密鑰。# 修補虛擬機以替換 secretRef 名稱
VOLUME_INDEX=$(kubectl get vm $VM_NAME -n $NAMESPACE -o json | jq '.spec.template.spec.volumes | to_entries[] | select(.value.cloudInitNoCloud != null) | .key')
kubectl patch vm $VM_NAME -n $VM_NAMESPACE --type='json' \
-p='[{"op": "replace", "path": "/spec/template/spec/volumes/'$VOLUME_INDEX'/cloudInitNoCloud/secretRef/name", "value": "'"$NEW_SECRET"'"}, {"op": "replace", "path": "/spec/template/spec/volumes/'$VOLUME_INDEX'/cloudInitNoCloud/networkDataSecretRef/name", "value": "'"$NEW_SECRET"'"}]'
一旦 Cloud Config 由唯一密鑰支援,您就可以使用 Harvester UI 的 YAML 編輯器編輯虛擬機配置,而不會影響來源範本。
相關問題:#9207