Monitoring
以下章節包含對 Harvester 監控進行故障排除的提示。
監控無法使用
當 Harvester 儀表板未顯示任何監控指標時,可能由以下原因造成。
由於 Pod 卡在 Terminating 狀態導致監控無法使用
Harvester 監控 Pod 會隨機部署在叢集節點上。當託管 Pod 的節點意外停止運作時,相關 Pod 可能會卡在 Terminating 狀態,導致監控從 WebUI 無法使用。
$ kubectl get pods -n cattle-monitoring-system

NAMESPACE                   NAME                                                     READY   STATUS        RESTARTS   AGE
cattle-monitoring-system    prometheus-rancher-monitoring-prometheus-0               3/3     Terminating   0          3d23h
cattle-monitoring-system    rancher-monitoring-admission-create-fwjn9                0/1     Terminating   0          137m
cattle-monitoring-system    rancher-monitoring-crd-create-9wtzf                      0/1     Terminating   0          137m
cattle-monitoring-system    rancher-monitoring-grafana-d9c56d79b-ph4nz               3/3     Terminating   0          3d23h
cattle-monitoring-system    rancher-monitoring-grafana-d9c56d79b-t24sz               0/3     Init:0/2      0          132m

cattle-monitoring-system    rancher-monitoring-kube-state-metrics-5bc8bb48bd-nbd92   1/1     Running       4          4d1h
...
可以使用 CLI 命令強制刪除相關 Pod 來恢復監控。叢集將重新部署新的 Pod 來替換它們。
# 刪除 cattle-monitoring-system 命名空間中的每個非執行中 Pod。

$ kubectl delete pod --force -n cattle-monitoring-system prometheus-rancher-monitoring-prometheus-0

 pod "prometheus-rancher-monitoring-prometheus-0" force deleted


$ kubectl delete pod --force -n cattle-monitoring-system rancher-monitoring-admission-create-fwjn9

$ kubectl delete pod --force -n cattle-monitoring-system rancher-monitoring-crd-create-9wtzf

$ kubectl delete pod --force -n cattle-monitoring-system rancher-monitoring-grafana-d9c56d79b-ph4nz

$ kubectl delete pod --force -n cattle-monitoring-system rancher-monitoring-grafana-d9c56d79b-t24sz
等待幾分鐘,以便建立新的 Pod 並準備就緒,監控儀表板即可再次使用。
$ kubectl get pods -n cattle-monitoring-system

NAME                                                     READY   STATUS     RESTARTS   AGE
prometheus-rancher-monitoring-prometheus-0               0/3     Init:0/1   0          98s
rancher-monitoring-grafana-d9c56d79b-cp86w               0/3     Init:0/2   0          27s
...

$ kubectl get pods -n cattle-monitoring-system

NAME                                                     READY   STATUS    RESTARTS   AGE
prometheus-rancher-monitoring-prometheus-0               3/3     Running   0          7m57s
rancher-monitoring-grafana-d9c56d79b-cp86w               3/3     Running   0          6m46s
...
擴展 PV/儲存區大小
Harvester 整合了 Longhorn 作為預設儲存提供者。
Harvester Monitoring 使用 Persistent Volume (PV) 來儲存執行資料。當叢集執行一段時間後,Persistent Volume 可能需要擴展其大小。
基於 Longhorn Volume 擴展指南,Harvester 說明如何擴展儲存區大小。
檢視儲存區
從嵌入式 Longhorn WebUI
根據此文件存取嵌入式 Longhorn WebUI。
Longhorn 儀表板預設檢視。
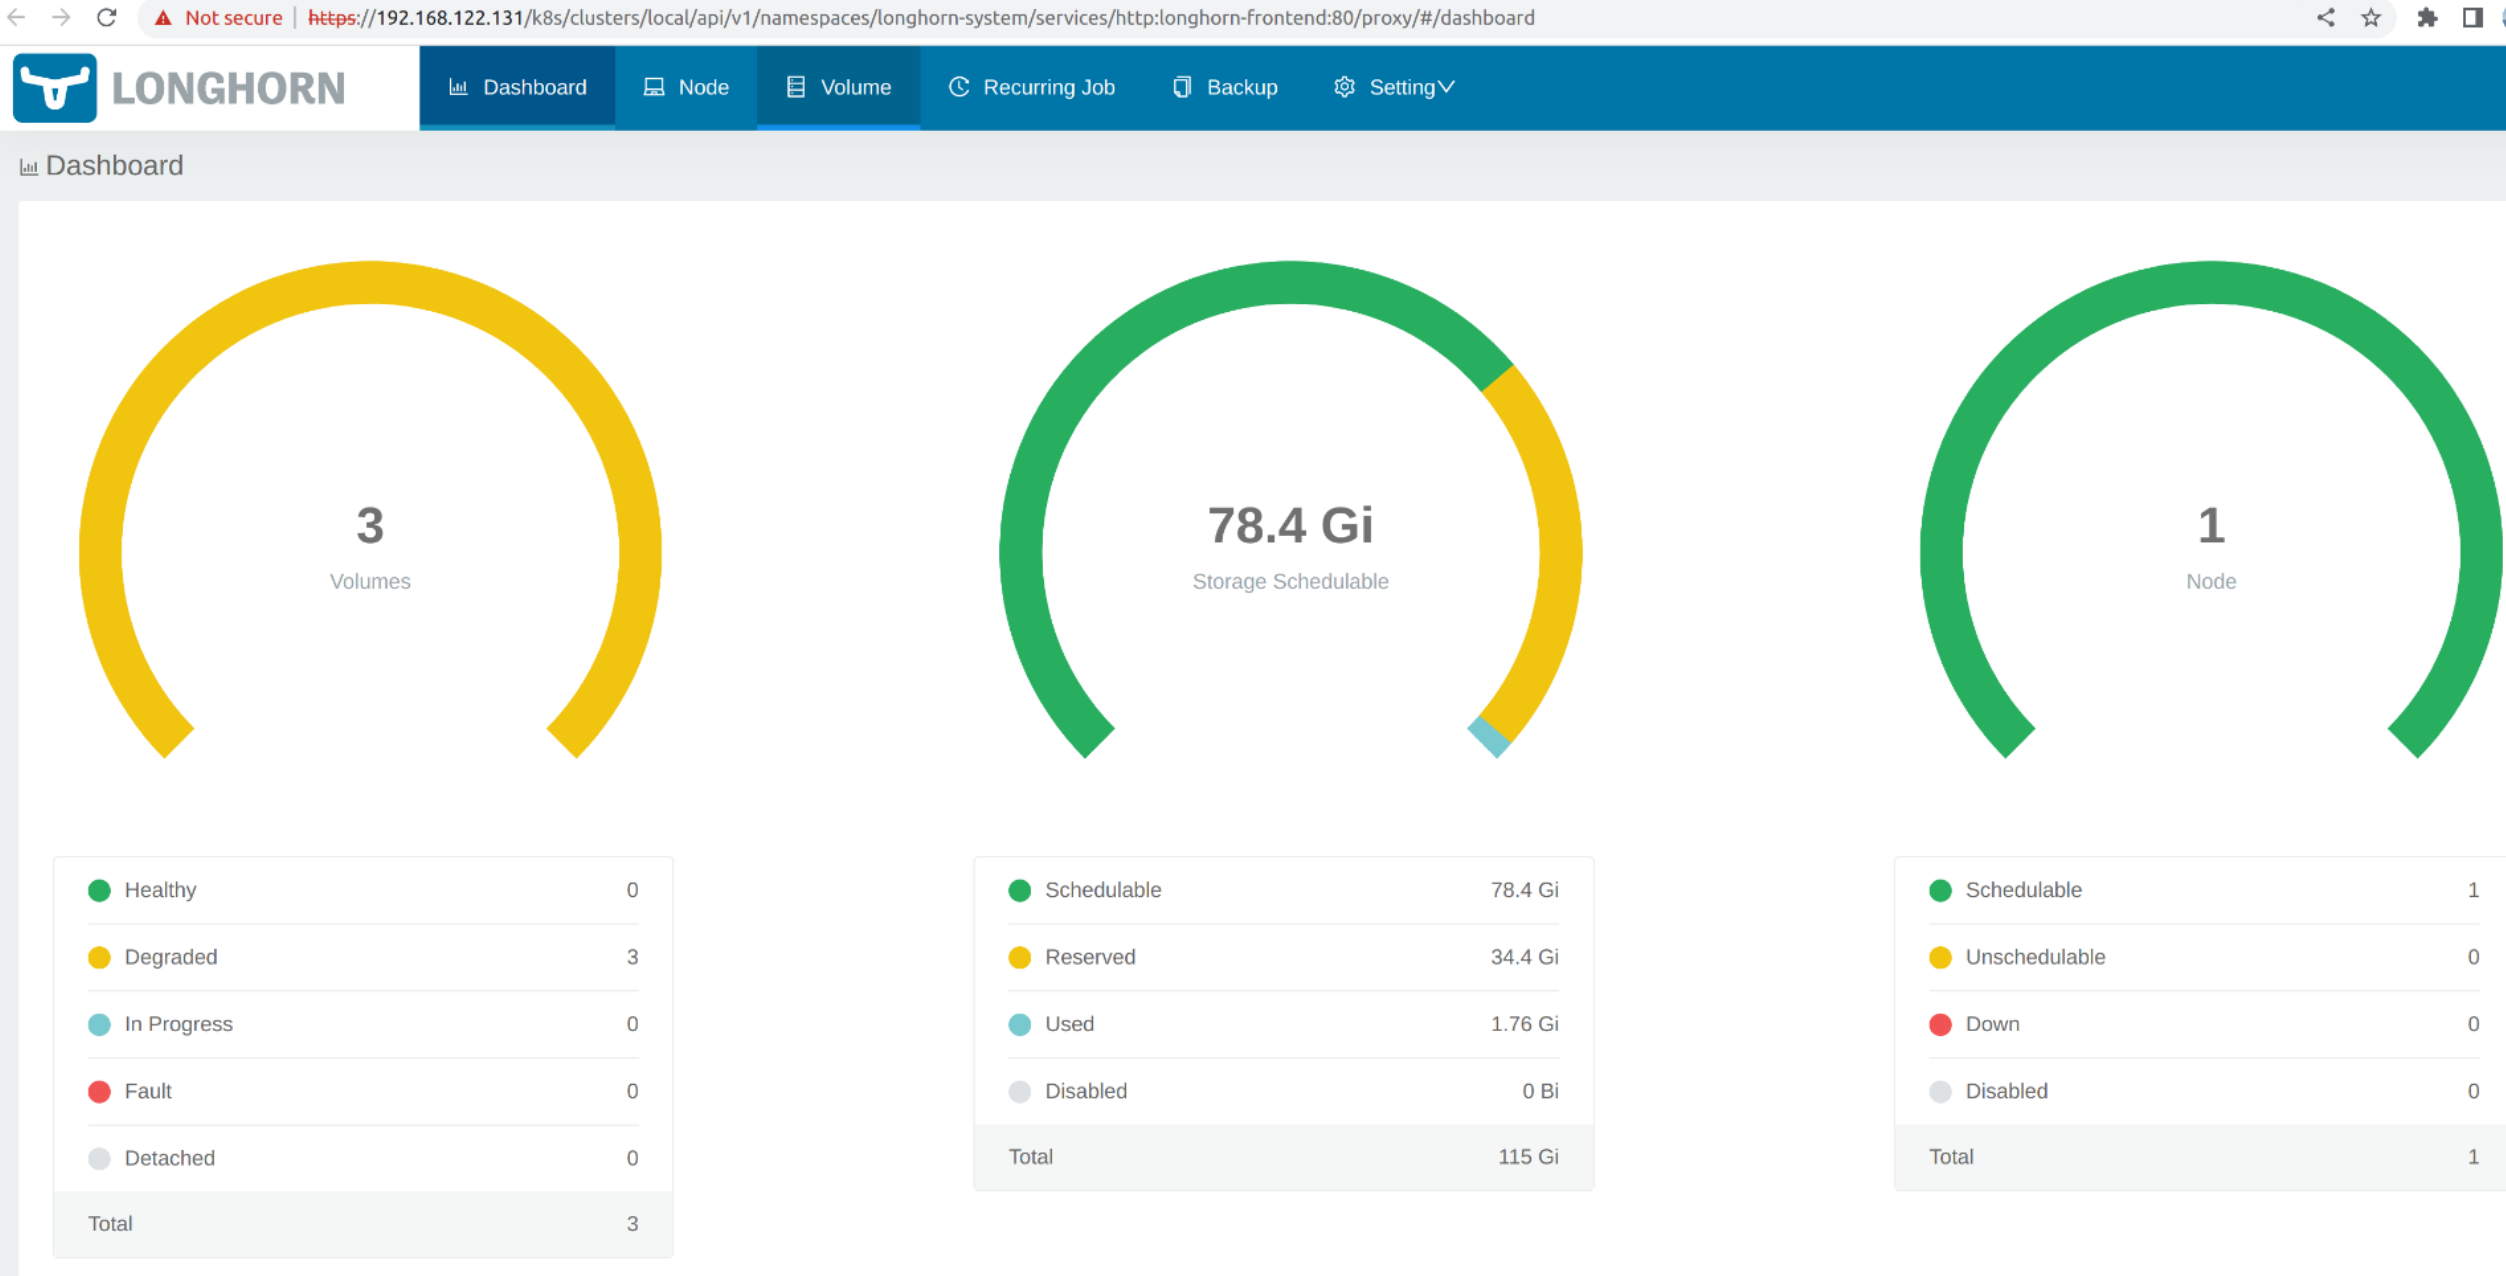
點擊 Volume 以列出所有現有儲存區。
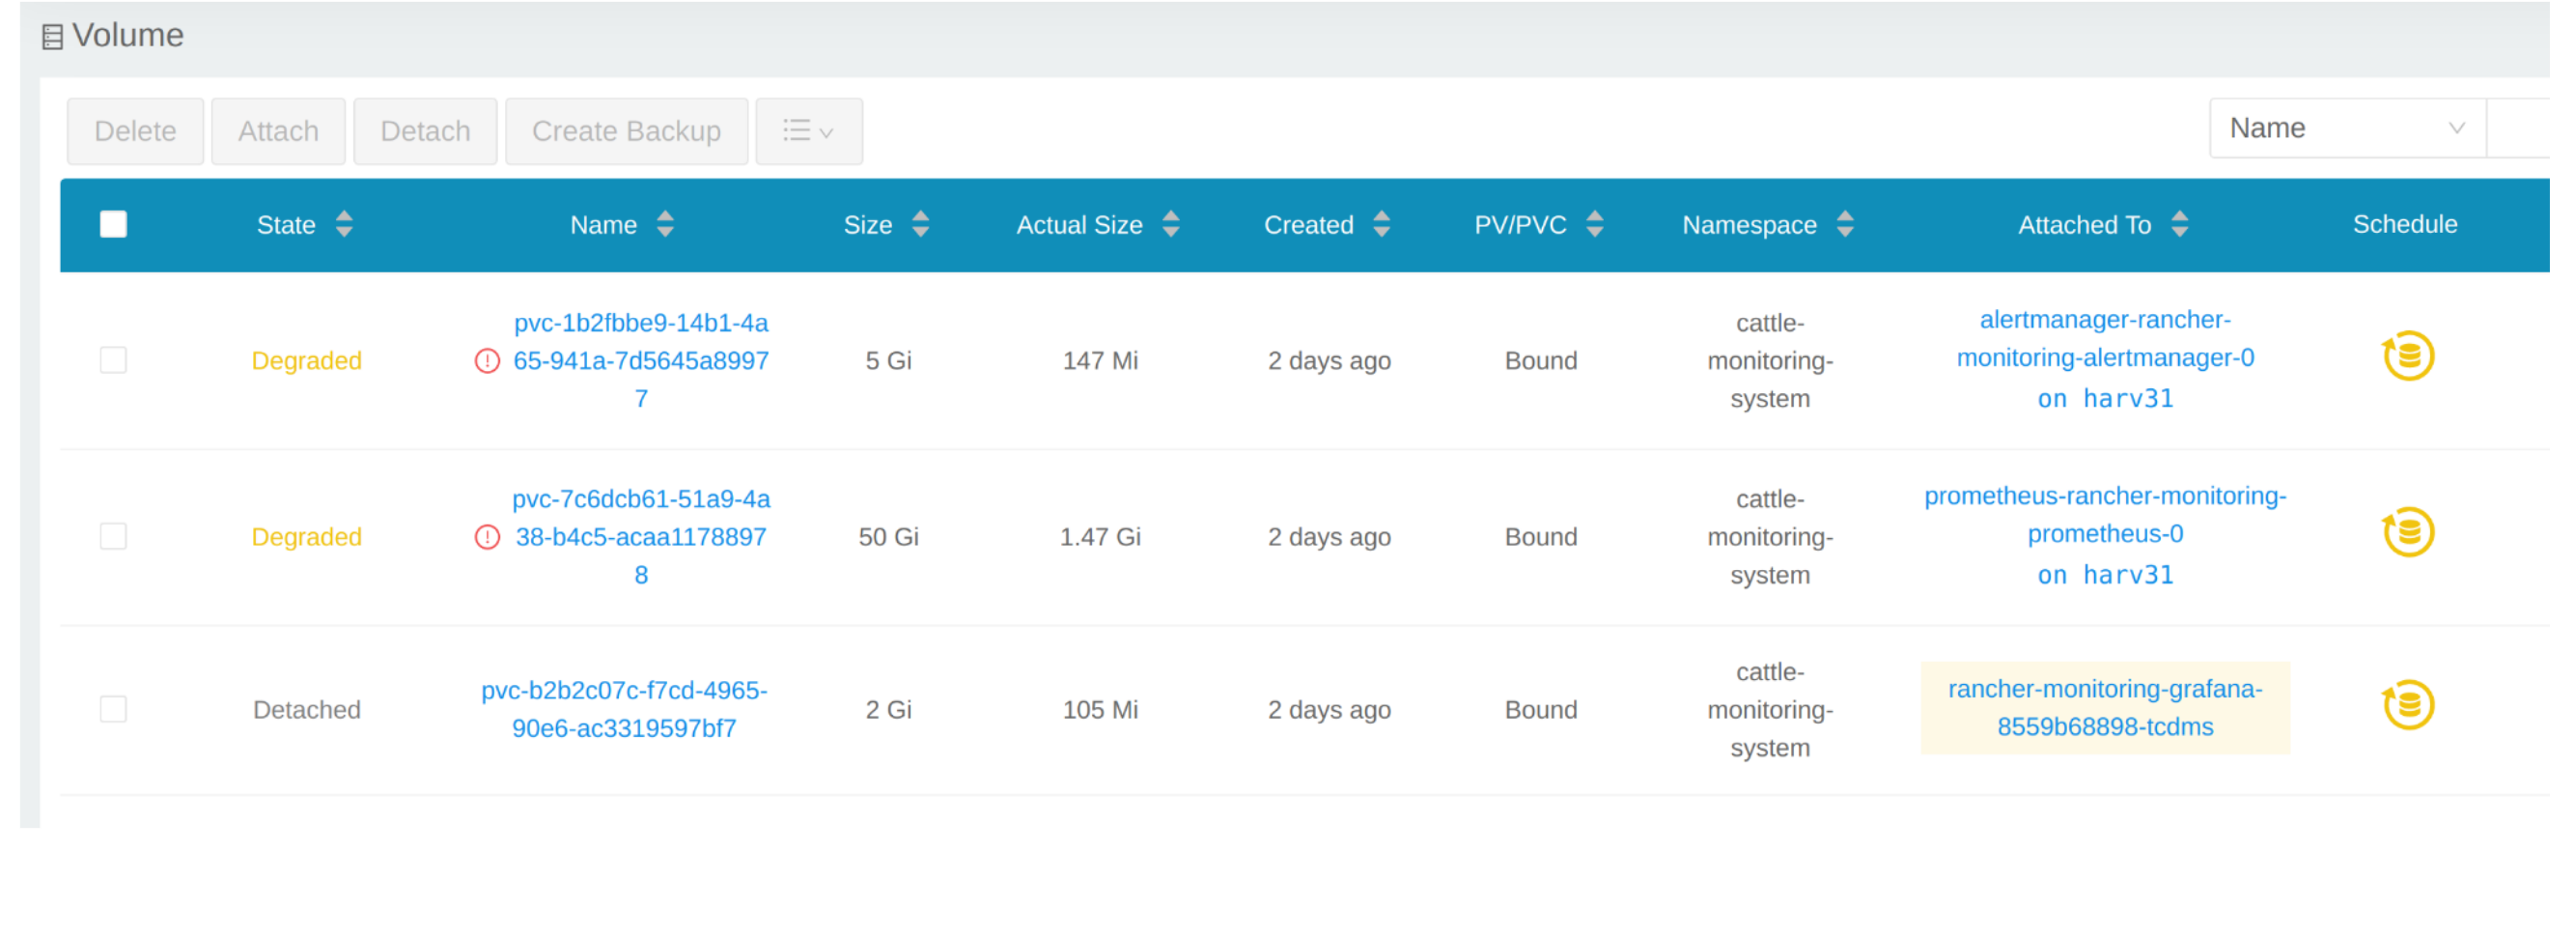
從 CLI
您也可以使用 kubectl 取得所有儲存區。
# kubectl get pvc -A
NAMESPACE                  NAME                                                                                             STATUS   VOLUME                                     CAPACITY   ACCESS MODES   STORAGECLASS         AGE
cattle-monitoring-system   alertmanager-rancher-monitoring-alertmanager-db-alertmanager-rancher-monitoring-alertmanager-0   Bound    pvc-1b2fbbe9-14b1-4a65-941a-7d5645a89977   5Gi        RWO            harvester-longhorn   43h
cattle-monitoring-system   prometheus-rancher-monitoring-prometheus-db-prometheus-rancher-monitoring-prometheus-0           Bound    pvc-7c6dcb61-51a9-4a38-b4c5-acaa11788978   50Gi       RWO            harvester-longhorn   43h
cattle-monitoring-system   rancher-monitoring-grafana                                                                       Bound    pvc-b2b2c07c-f7cd-4965-90e6-ac3319597bf7   2Gi        RWO            harvester-longhorn   43h

# kubectl get volume -A
NAMESPACE         NAME                                       STATE      ROBUSTNESS   SCHEDULED   SIZE          NODE     AGE
longhorn-system   pvc-1b2fbbe9-14b1-4a65-941a-7d5645a89977   attached   degraded                 5368709120    harv31   43h
longhorn-system   pvc-7c6dcb61-51a9-4a38-b4c5-acaa11788978   attached   degraded                 53687091200   harv31   43h
longhorn-system   pvc-b2b2c07c-f7cd-4965-90e6-ac3319597bf7   attached   degraded                 2147483648    harv31   43h
縮減部署
要分離 Volume,您需要縮減使用該 Volume 的 deployment。
以下範例針對 rancher-monitoring-grafana 宣告的 PVC。
在 cattle-monitoring-system 命名空間中尋找 deployment。
# kubectl get deployment -n cattle-monitoring-system
NAME                                    READY   UP-TO-DATE   AVAILABLE   AGE
rancher-monitoring-grafana              1/1     1            1           43h  // 目標 deployment
rancher-monitoring-kube-state-metrics   1/1     1            1           43h
rancher-monitoring-operator             1/1     1            1           43h
rancher-monitoring-prometheus-adapter   1/1     1            1           43h
將 deployment rancher-monitoring-grafana 縮減至 0。
# kubectl scale --replicas=0 deployment/rancher-monitoring-grafana -n cattle-monitoring-system
檢查 deployment 和儲存區。
# kubectl get deployment -n cattle-monitoring-system
NAME                                    READY   UP-TO-DATE   AVAILABLE   AGE
rancher-monitoring-grafana              0/0     0            0           43h  // 已縮減
rancher-monitoring-kube-state-metrics   1/1     1            1           43h
rancher-monitoring-operator             1/1     1            1           43h
rancher-monitoring-prometheus-adapter   1/1     1            1           43h

# kubectl get volume -A
NAMESPACE         NAME                                       STATE      ROBUSTNESS   SCHEDULED   SIZE          NODE     AGE
longhorn-system   pvc-1b2fbbe9-14b1-4a65-941a-7d5645a89977   attached   degraded                 5368709120    harv31   43h
longhorn-system   pvc-7c6dcb61-51a9-4a38-b4c5-acaa11788978   attached   degraded                 53687091200   harv31   43h
longhorn-system   pvc-b2b2c07c-f7cd-4965-90e6-ac3319597bf7   detached   unknown                  2147483648             43h  // 儲存區已分離
擴展儲存區
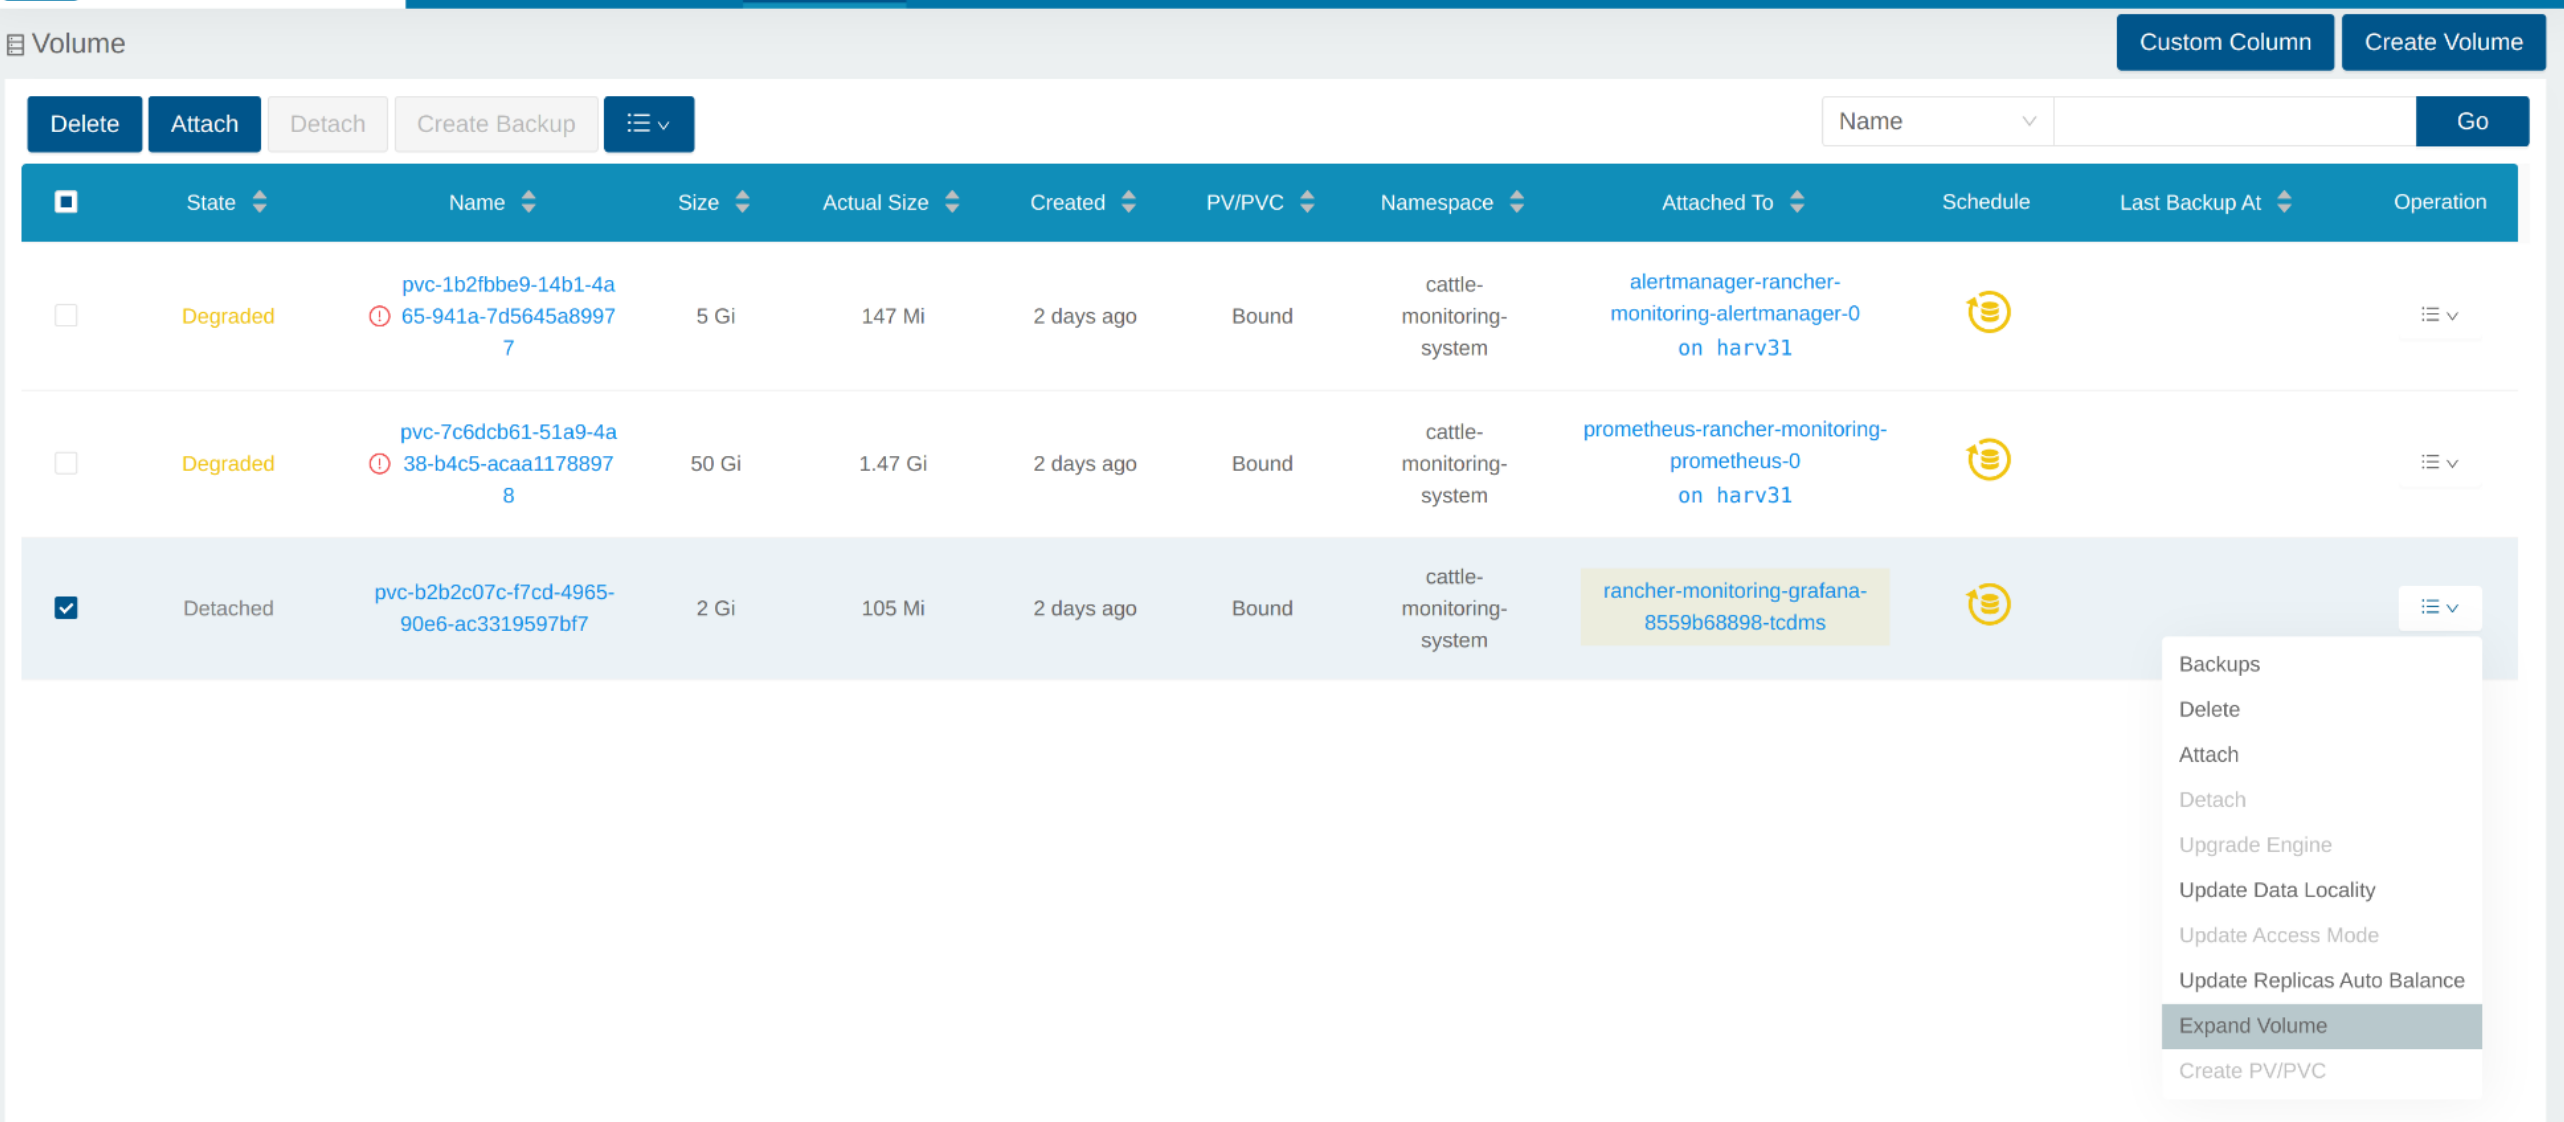
在 Longhorn WebUI 中,相關儲存區變為 Detached。點擊 Operation 欄中的圖示,然後選擇 Expand Volume。
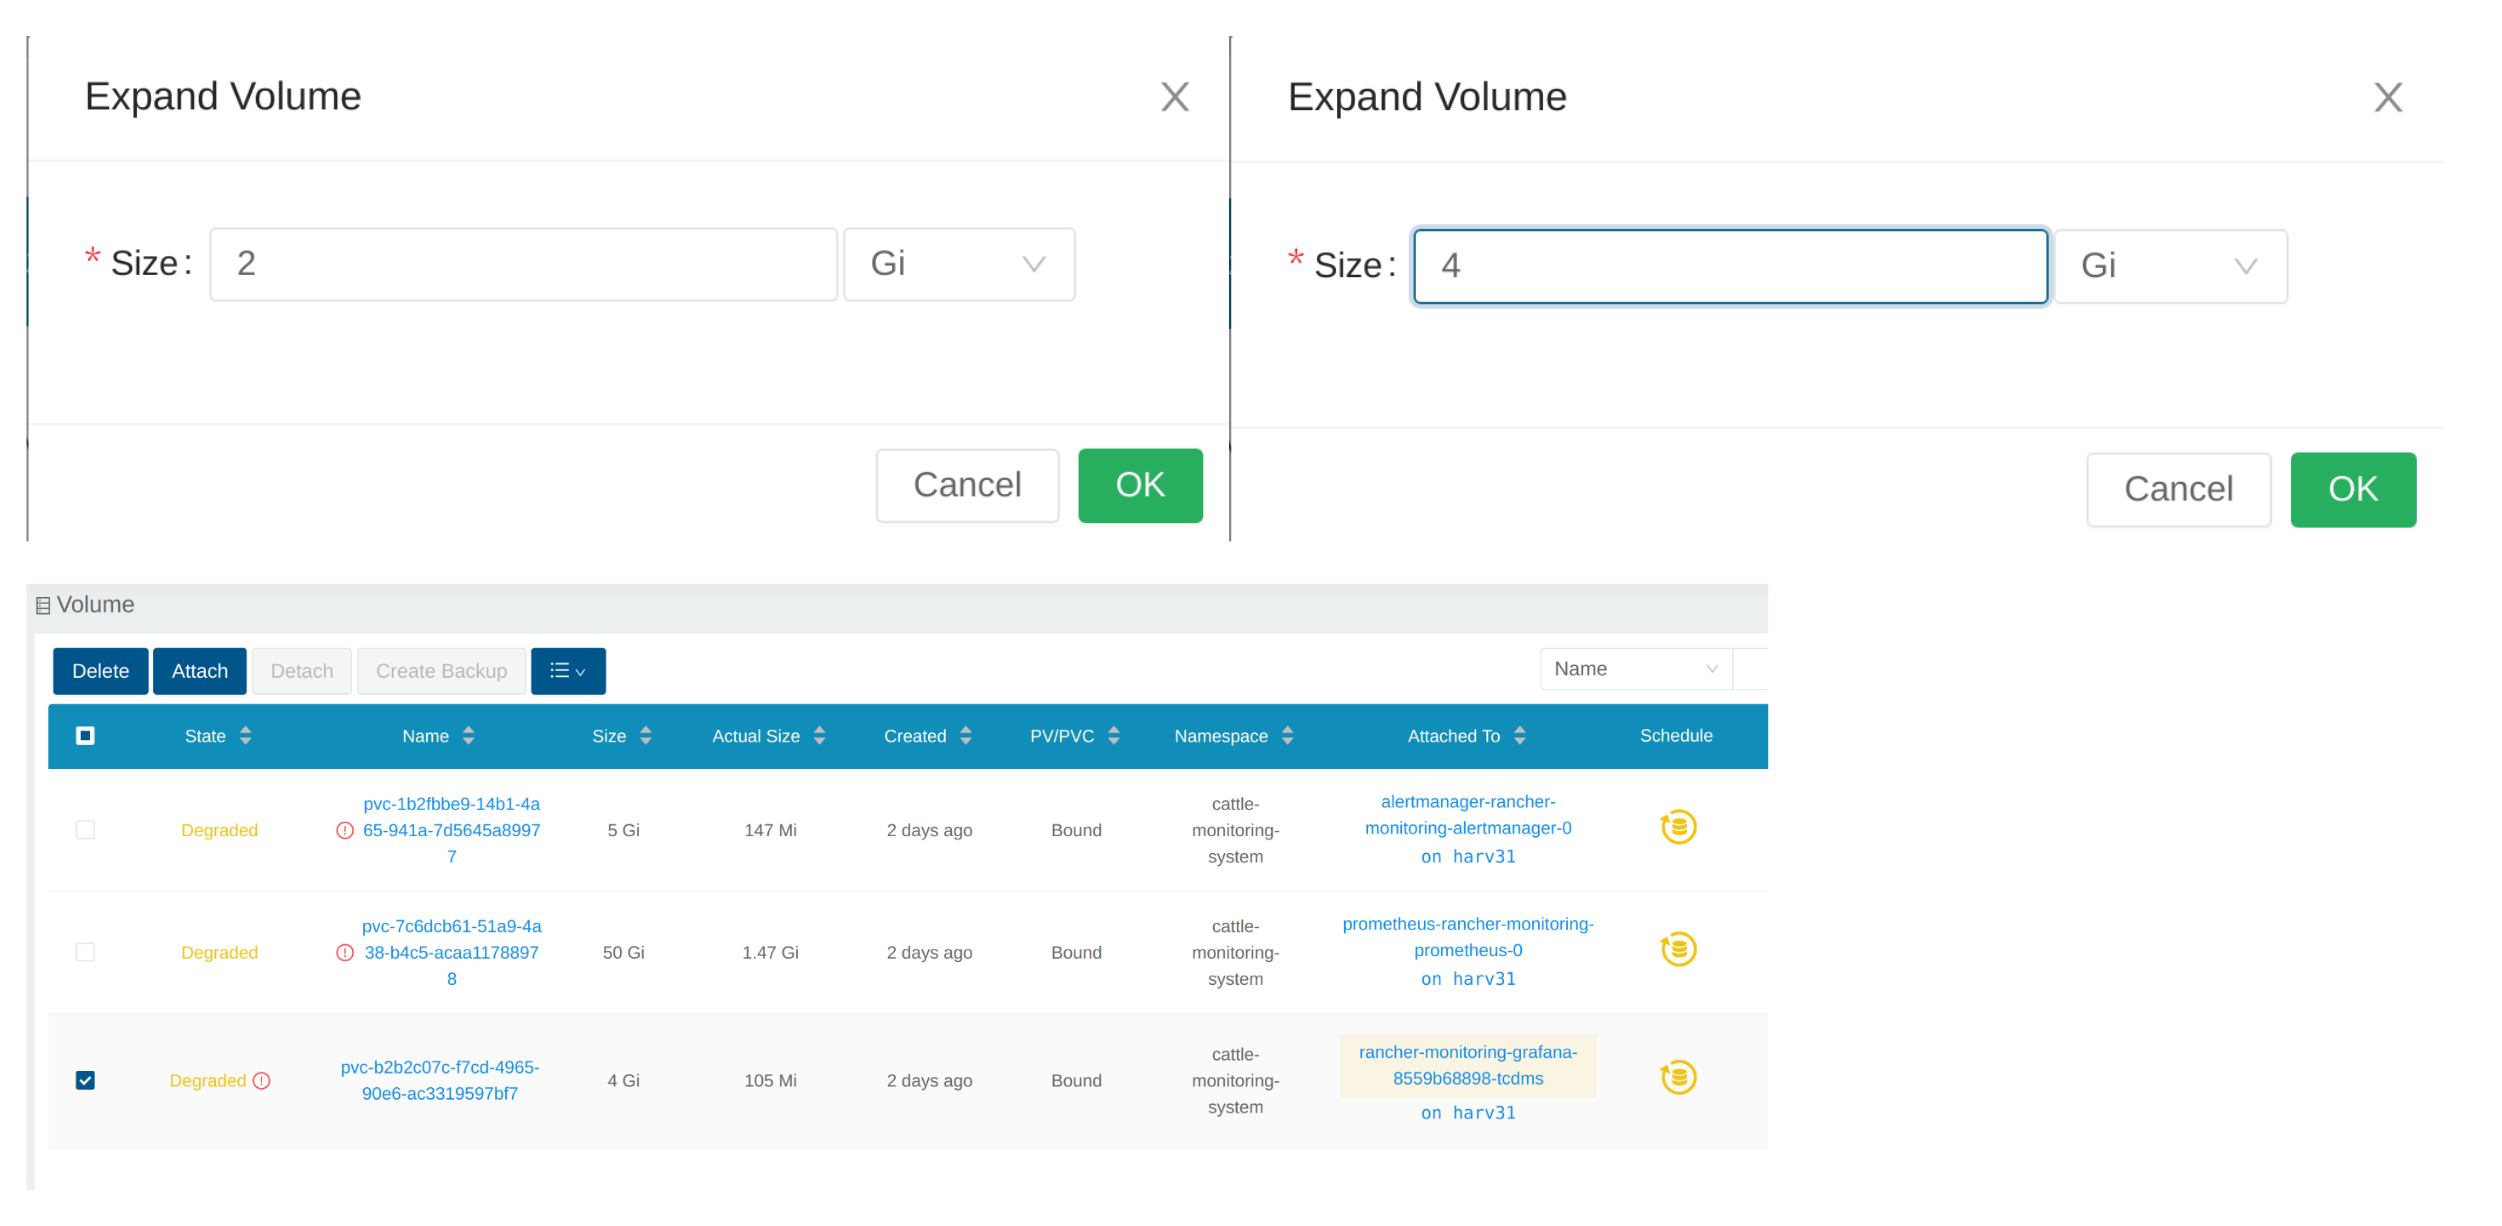
輸入新大小,Longhorn 將把儲存區擴展到此大小。
擴展部署
在 Volume 擴展到目標大小後,您需要將前述 deployment 擴展到其原始副本數。對於上述 rancher-monitoring-grafana 範例,原始副本數為 1。
# kubectl scale --replicas=1 deployment/rancher-monitoring-grafana -n cattle-monitoring-system
再次檢查 deployment。
# kubectl get deployment -n cattle-monitoring-system
NAME                                    READY   UP-TO-DATE   AVAILABLE   AGE
rancher-monitoring-grafana              1/1     1            1           43h  // 已擴展
rancher-monitoring-kube-state-metrics   1/1     1            1           43h
rancher-monitoring-operator             1/1     1            1           43h
rancher-monitoring-prometheus-adapter   1/1     1            1           43h
Volume 已附加到新 POD。
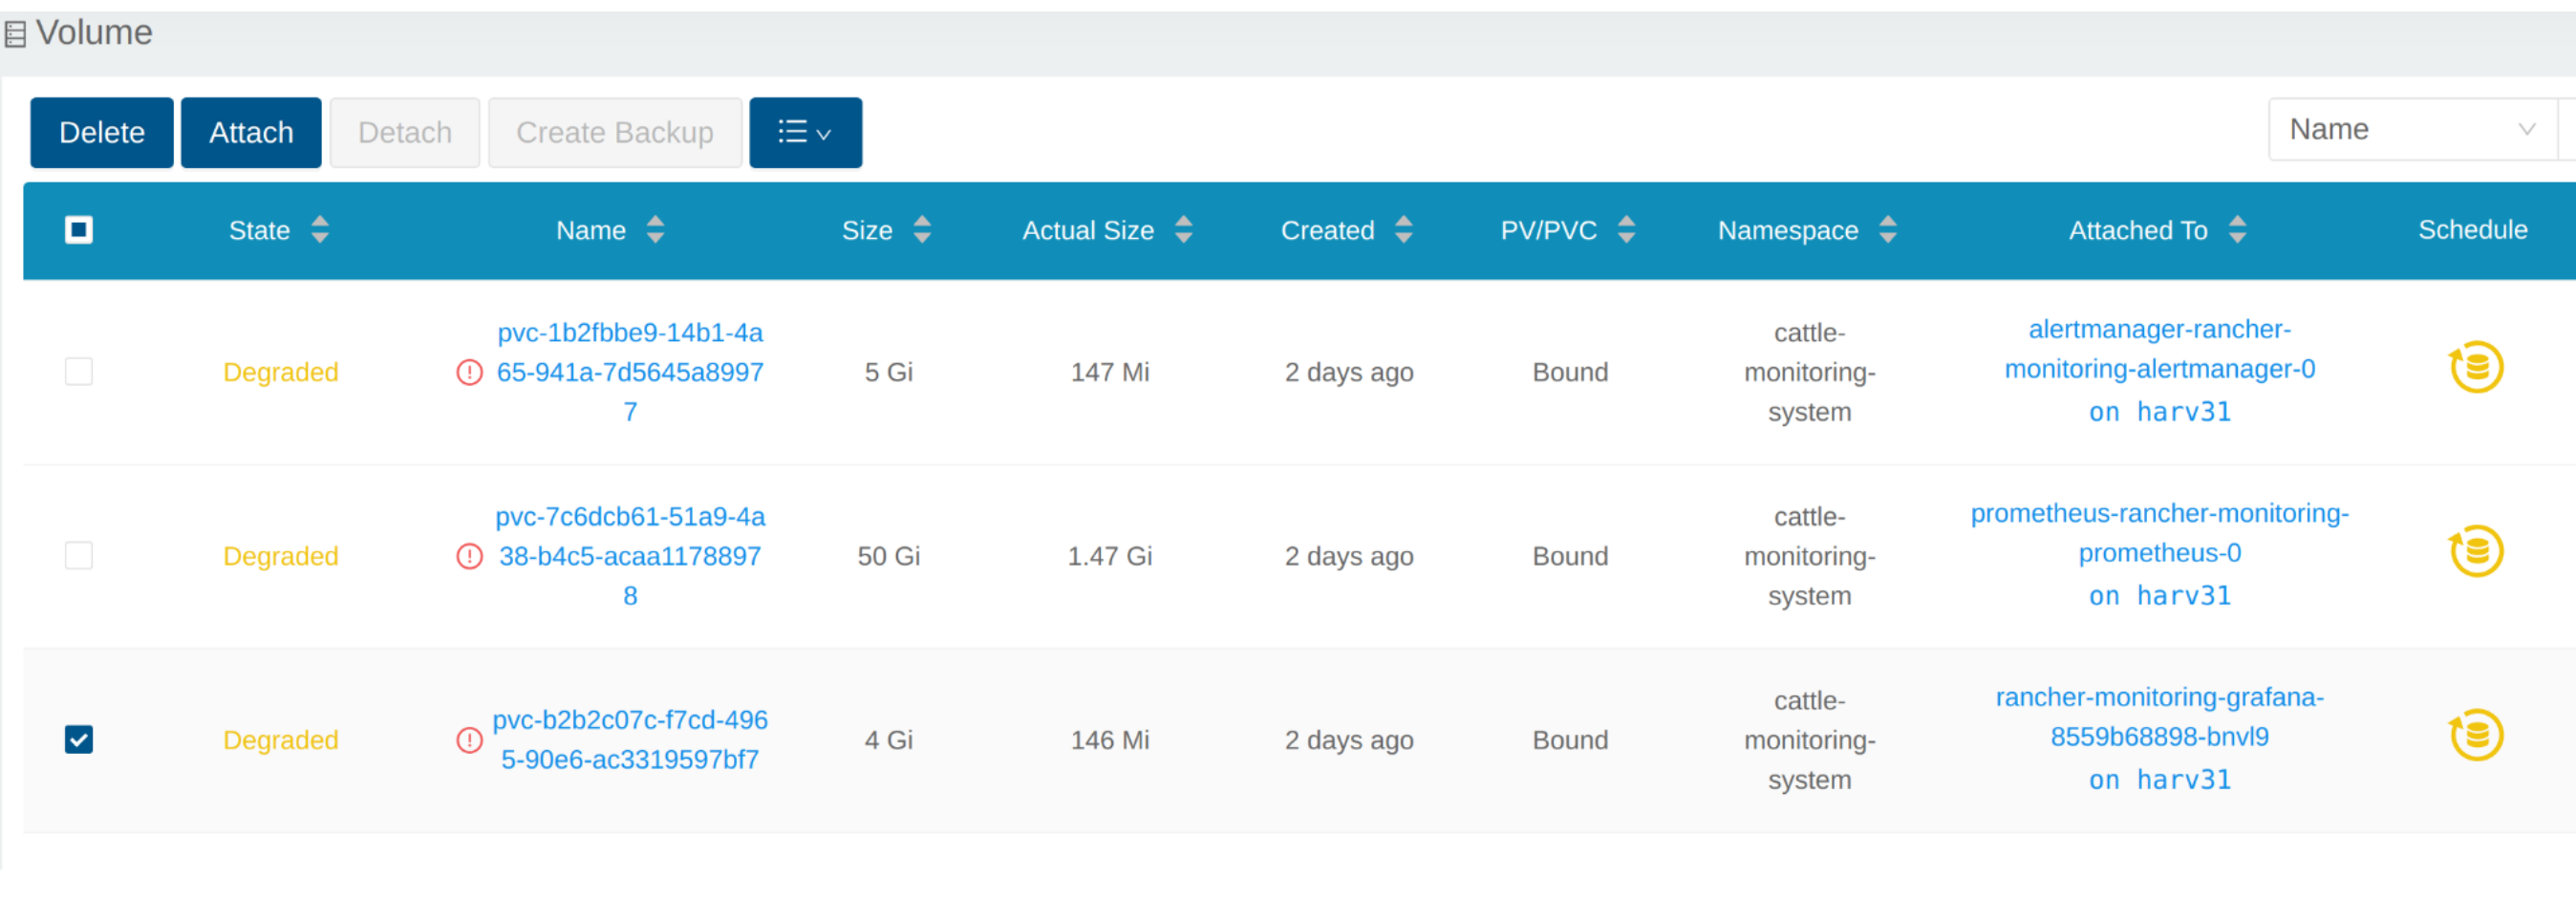
至此,Volume 已擴展到新大小,POD 正在順利使用它。
無法啟用 rancher-monitoring 附加元件
當您按照硬體需求使用每個節點最低 250 GB 磁碟安裝 Harvester v1.3.0 或更高版本叢集時,您可能會遇到此問題。
重現步驟
-
安裝 Harvester v1.3.0 叢集。
-
啟用
rancher-monitoring附加元件,您將觀察到:
-
cattle-monitoring-system命名空間中的 PODprometheus-rancher-monitoring-prometheus-0由於 PVC 附加失敗而無法啟動。$ kubectl get pods -n cattle-monitoring-system
NAME READY STATUS RESTARTS AGE
alertmanager-rancher-monitoring-alertmanager-0 2/2 Running 0 3m22s
helm-install-rancher-monitoring-4b5mx 0/1 Completed 0 3m41s
prometheus-rancher-monitoring-prometheus-0 0/3 Init:0/1 0 3m21s // 卡在此狀態
rancher-monitoring-grafana-d6f466988-hgpkb 4/4 Running 0 3m26s
rancher-monitoring-kube-state-metrics-7659b76cc4-66sr7 1/1 Running 0 3m26s
rancher-monitoring-operator-595476bc84-7hdxj 1/1 Running 0 3m25s
rancher-monitoring-prometheus-adapter-55dc9ccd5d-pcrpk 1/1 Running 0 3m26s
rancher-monitoring-prometheus-node-exporter-pbzv4 1/1 Running 0 3m26s
$ kubectl describe pod -n cattle-monitoring-system prometheus-rancher-monitoring-prometheus-0
Name: prometheus-rancher-monitoring-prometheus-0
Namespace: cattle-monitoring-system
Priority: 0
Service Account: rancher-monitoring-prometheus
...
Events:
Type Reason Age From Message
---- ------ ---- ---- -------
Warning FailedScheduling 3m48s (x3 over 4m15s) default-scheduler 0/1 nodes are available: pod has unbound immediate PersistentVolumeClaims. preemption: 0/1 nodes are available: 1 Preemption is not helpful for scheduling..
Normal Scheduled 3m44s default-scheduler Successfully assigned cattle-monitoring-system/prometheus-rancher-monitoring-prometheus-0 to harv41
Warning FailedMount 101s kubelet Unable to attach or mount volumes: unmounted volumes=[prometheus-rancher-monitoring-prometheus-db], unattached volumes=[prometheus-rancher-monitoring-prometheus-db], failed to process volumes=[]: timed out waiting for the condition
Warning FailedAttachVolume 90s (x9 over 3m42s) attachdetach-controller AttachVolume.Attach failed for volume "pvc-bbe8760d-926c-484a-851c-b8ec29ae05c0" : rpc error: code = Aborted desc = volume pvc-bbe8760d-926c-484a-851c-b8ec29ae05c0 is not ready for workloads
$ kubectl get pvc -A
NAMESPACE NAME STATUS VOLUME CAPACITY ACCESS MODES STORAGECLASS AGE
cattle-monitoring-system prometheus-rancher-monitoring-prometheus-db-prometheus-rancher-monitoring-prometheus-0 Bound pvc-bbe8760d-926c-484a-851c-b8ec29ae05c0 50Gi RWO harvester-longhorn 7m12s
$ kubectl get volume -A
NAMESPACE NAME DATA ENGINE STATE ROBUSTNESS SCHEDULED SIZE NODE AGE
longhorn-system pvc-bbe8760d-926c-484a-851c-b8ec29ae05c0 v1 detached unknown 53687091200 6m55s -
Longhorn 管理器無法排程副本。
$ kubectl logs -n longhorn-system longhorn-manager-bf65b | grep "pvc-bbe8760d-926c-484a-851c-b8ec29ae05c0"

time="2024-02-19T10:12:56Z" level=error msg="There's no available disk for replica pvc-bbe8760d-926c-484a-851c-b8ec29ae05c0-r-dcb129fd, size 53687091200" func="schedule
r.(*ReplicaScheduler).ScheduleReplica" file="replica_scheduler.go:95"
time="2024-02-19T10:12:56Z" level=warning msg="Failed to schedule replica" func="controller.(*VolumeController).reconcileVolumeCondition" file="volume_controller.go:169
4" accessMode=rwo controller=longhorn-volume frontend=blockdev migratable=false node=harv41 owner=harv41 replica=pvc-bbe8760d-926c-484a-851c-b8ec29ae05c0-r-dcb129fd sta
te= volume=pvc-bbe8760d-926c-484a-851c-b8ec29ae05c0
...
解決方法
-
如果您已啟用
rancher-monitoring附加元件,請停用它。cattle-monitoring-system中的所有 Pod 都會被刪除,但 PVC 會保留。如需更多資訊,請參閱 [Addons]。$ kubectl get pods -n cattle-monitoring-system
No resources found in cattle-monitoring-system namespace.
$ kubectl get pvc -n cattle-monitoring-system
NAME STATUS VOLUME CAPACITY ACCESS MODES STORAGECLASS AGE
alertmanager-rancher-monitoring-alertmanager-db-alertmanager-rancher-monitoring-alertmanager-0 Bound pvc-cea6316e-f74f-4771-870b-49edb5442819 5Gi RWO harvester-longhorn 14m
prometheus-rancher-monitoring-prometheus-db-prometheus-rancher-monitoring-prometheus-0 Bound pvc-bbe8760d-926c-484a-851c-b8ec29ae05c0 50Gi RWO harvester-longhorn 14m -
刪除名為
prometheus的 PVC,但保留名為alertmanager的 PVC。$ kubectl delete pvc -n cattle-monitoring-system prometheus-rancher-monitoring-prometheus-db-prometheus-rancher-monitoring-prometheus-0
persistentvolumeclaim "prometheus-rancher-monitoring-prometheus-db-prometheus-rancher-monitoring-prometheus-0" deleted
$ kubectl get pvc -n cattle-monitoring-system
NAME STATUS VOLUME CAPACITY ACCESS MODES STORAGECLASS AGE
alertmanager-rancher-monitoring-alertmanager-db-alertmanager-rancher-monitoring-alertmanager-0 Bound pvc-cea6316e-f74f-4771-870b-49edb5442819 5Gi RWO harvester-longhorn 16m -
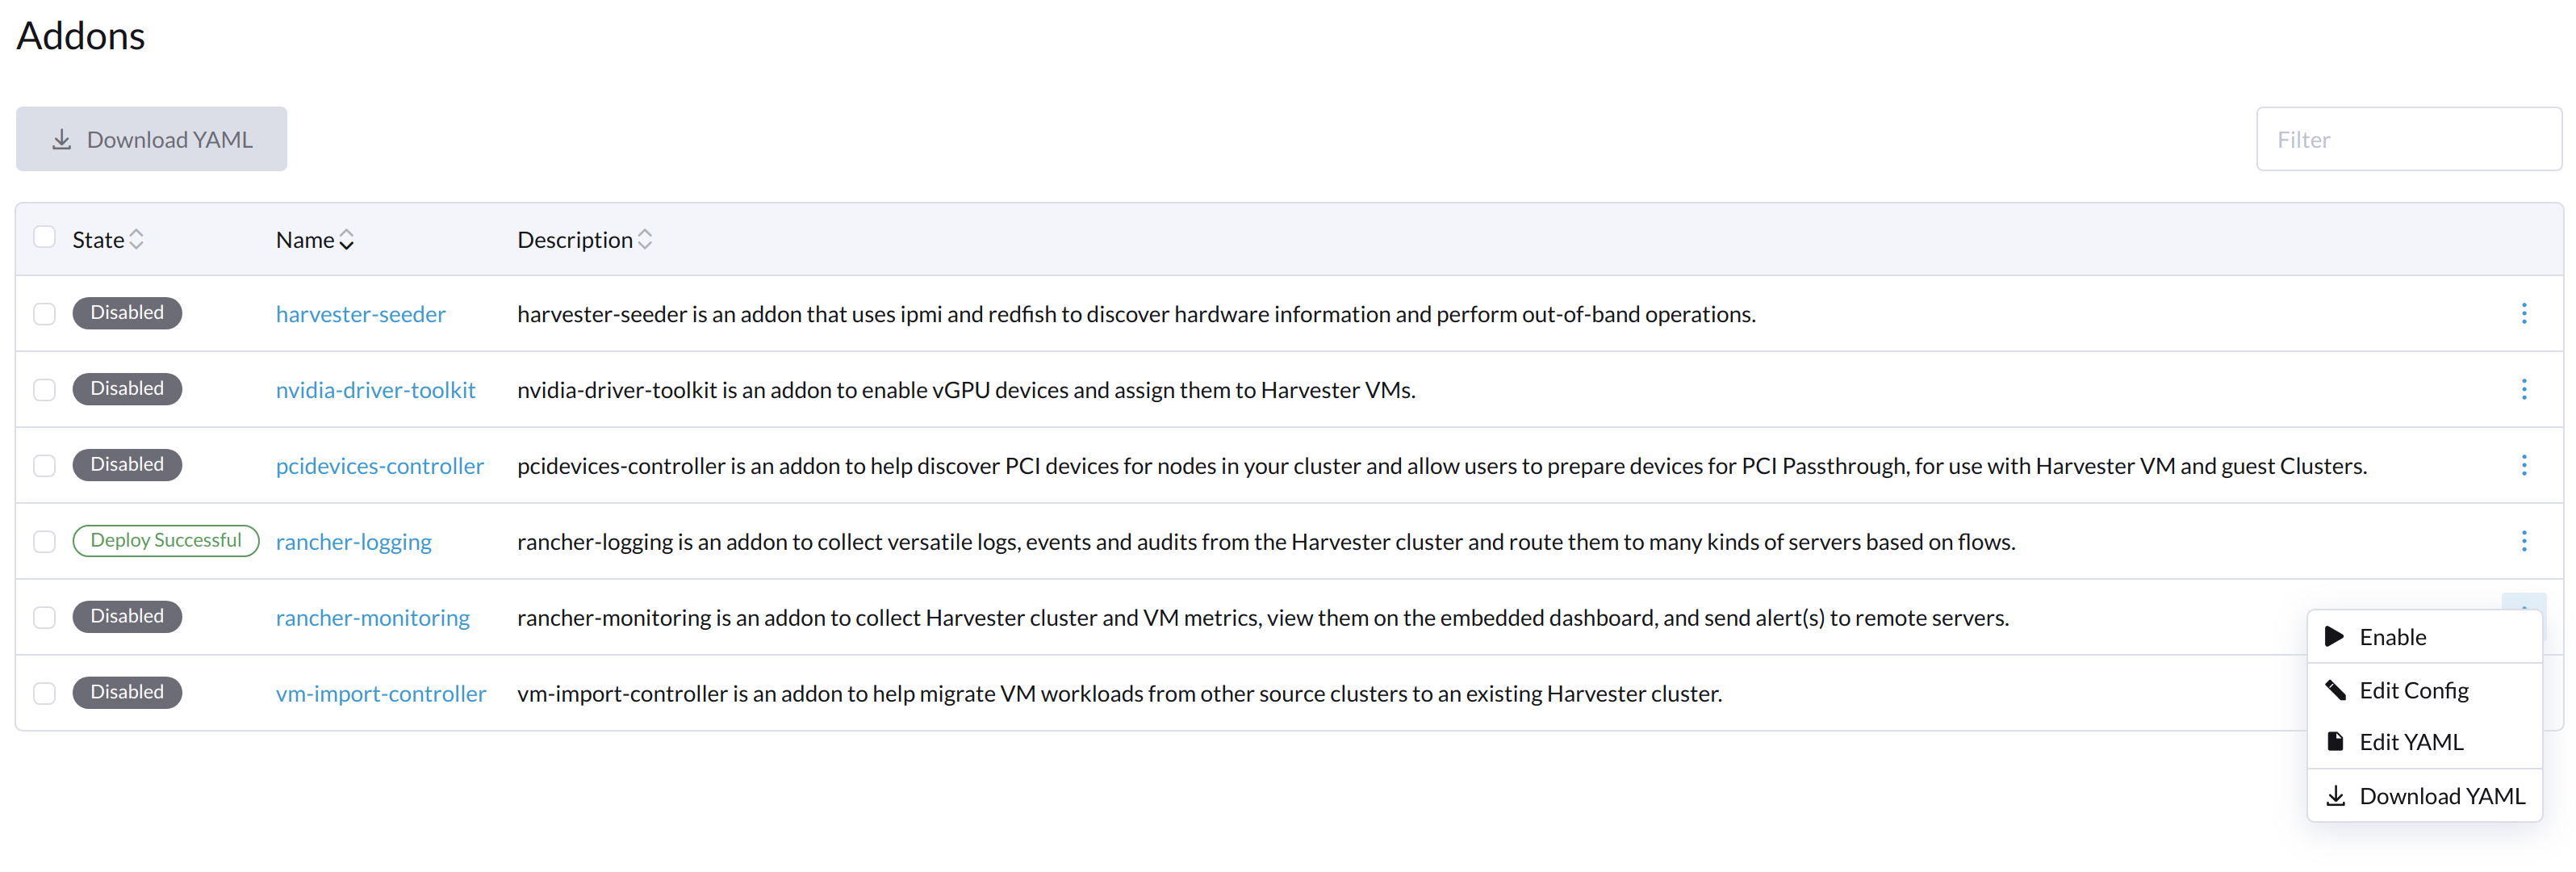
在 Harvester UI 的 Addons 畫面上,選擇 ⋮(選單圖示),然後選擇 Edit YAML。
-
如下所示,將 prometheusSpec 下出現的兩次數字
50變更為30,然後儲存。prometheus功能將使用 30GiB 磁碟來儲存資料。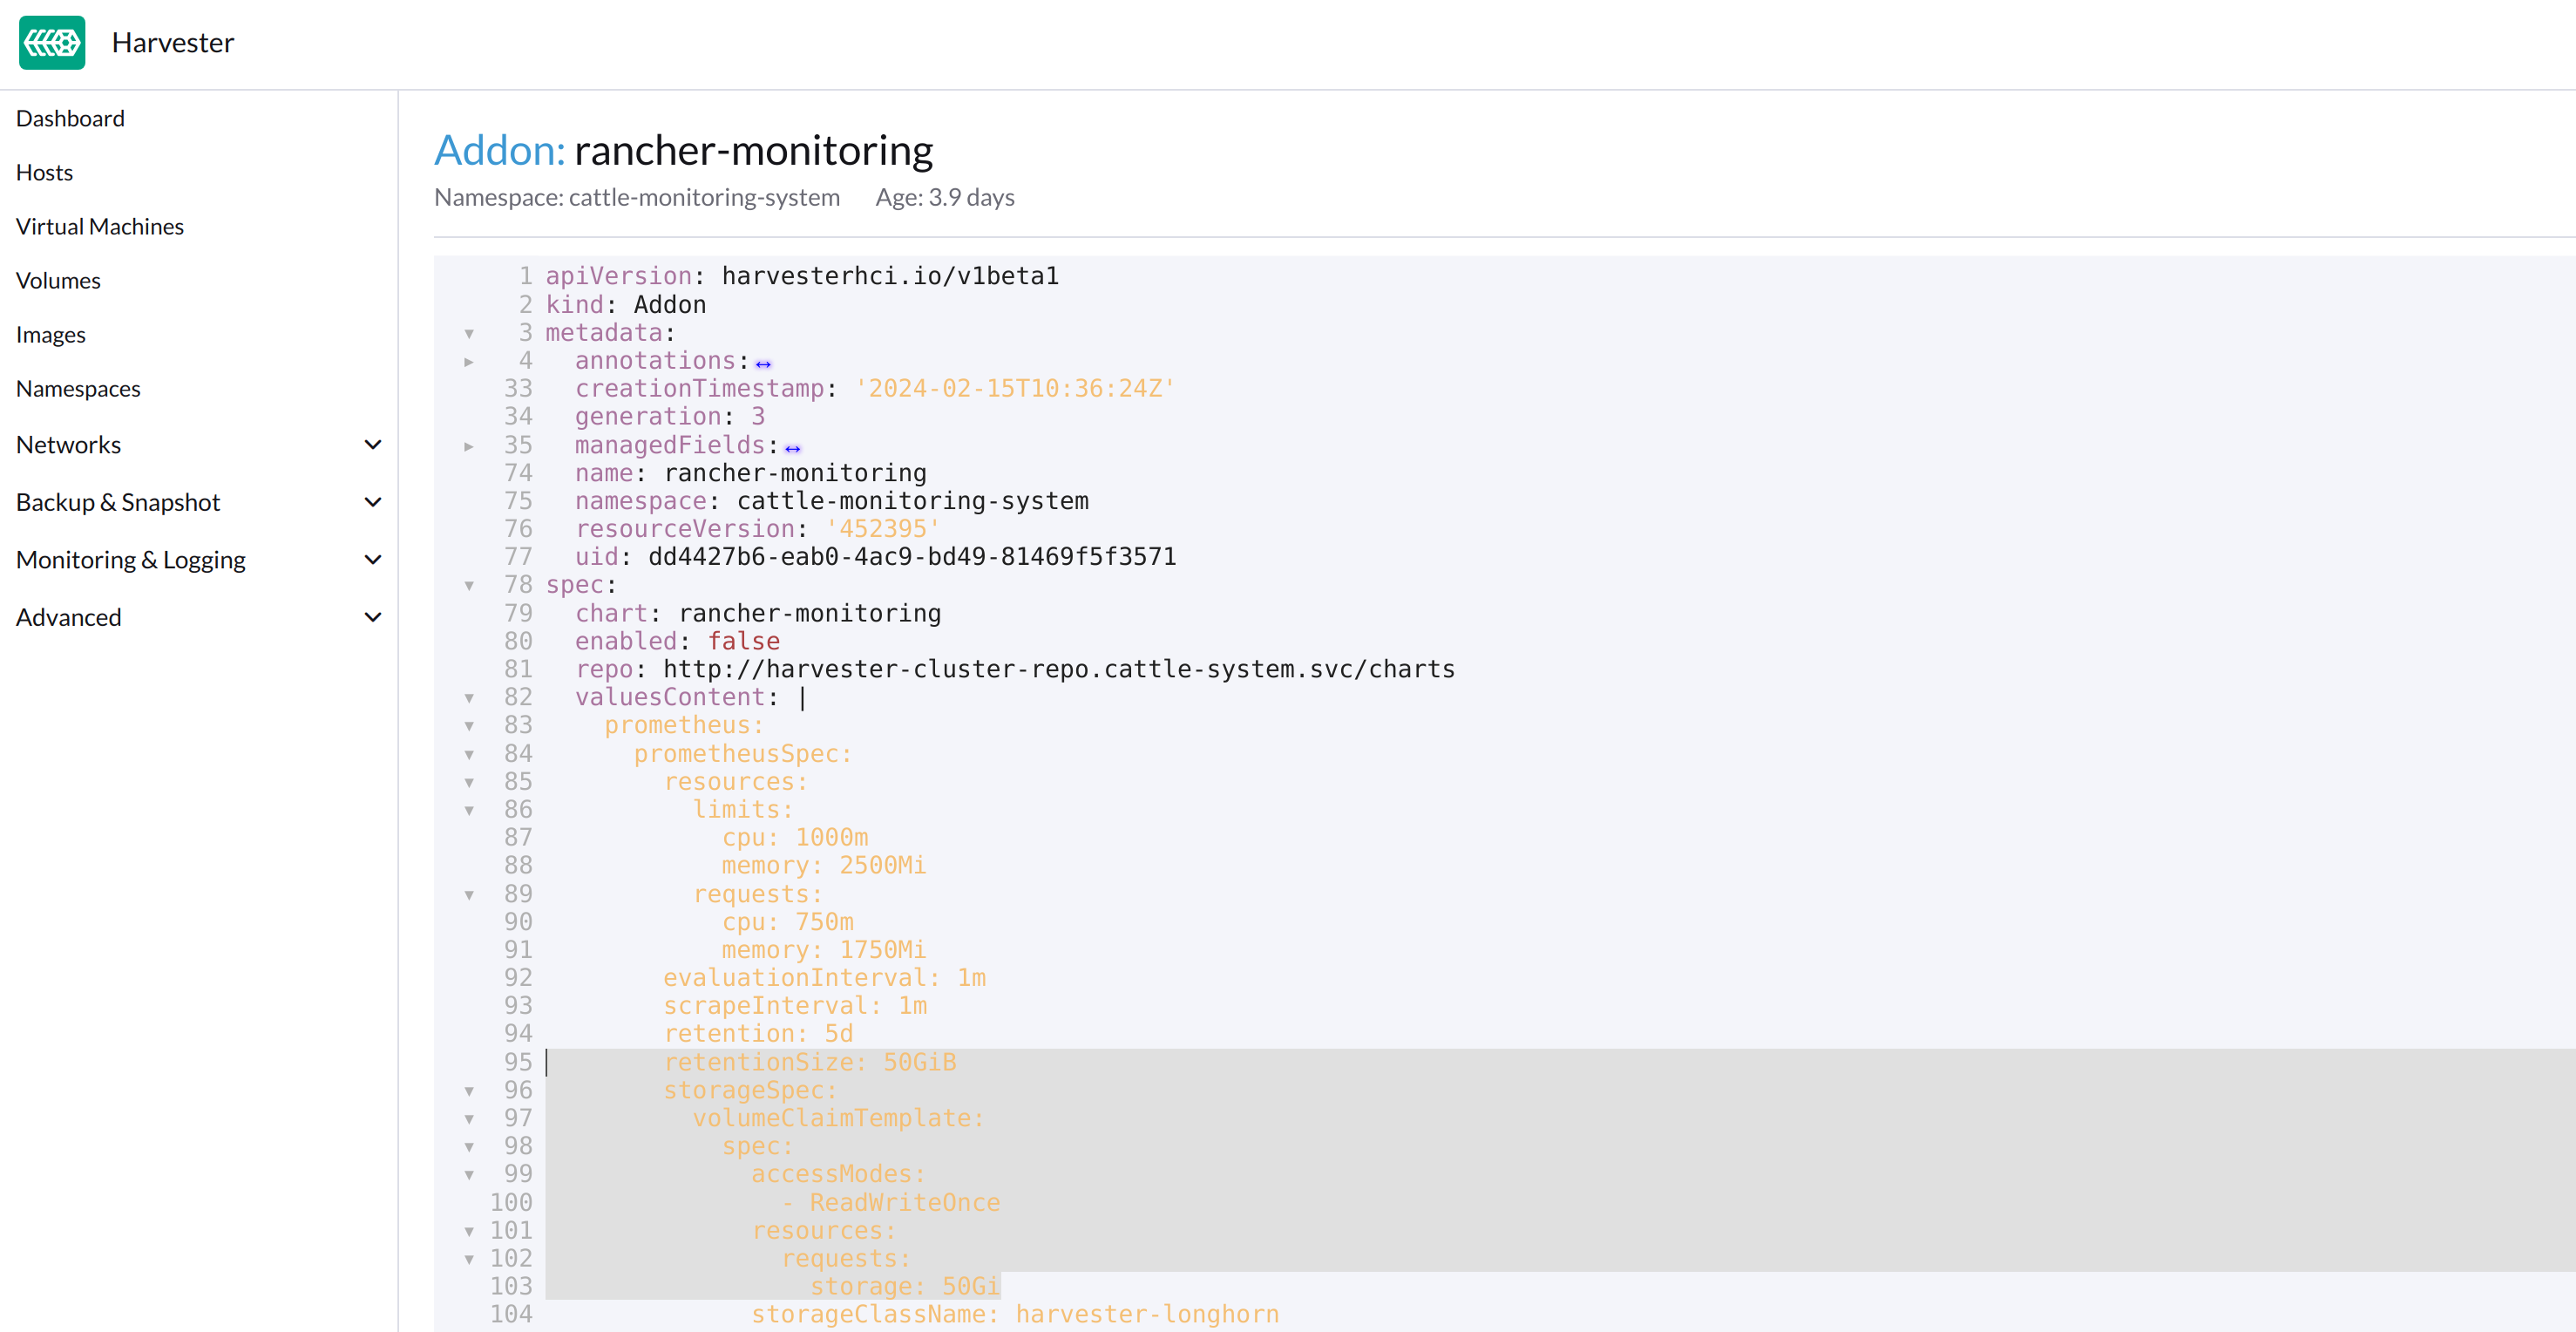
或者,您可以使用
kubectl編輯物件。kubectl edit addons.harvesterhci.io -n cattle-monitoring-system rancher-monitoringretentionSize: 50GiB // 將 50 變更為 30
storageSpec:
volumeClaimTemplate:
spec:
accessModes:
- ReadWriteOnce
resources:
requests:
storage: 50Gi // 將 50 變更為 30
storageClassName: harvester-longhorn -
啟用
rancher-monitoring附加元件並等待幾分鐘。 -
所有 Pod 都成功部署,
rancher-monitoring功能可用。$ kubectl get pods -n cattle-monitoring-system
NAME READY STATUS RESTARTS AGE
alertmanager-rancher-monitoring-alertmanager-0 2/2 Running 0 3m52s
helm-install-rancher-monitoring-s55tq 0/1 Completed 0 4m17s
prometheus-rancher-monitoring-prometheus-0 3/3 Running 0 3m51s
rancher-monitoring-grafana-d6f466988-hkv6f 4/4 Running 0 3m55s
rancher-monitoring-kube-state-metrics-7659b76cc4-ght8x 1/1 Running 0 3m55s
rancher-monitoring-operator-595476bc84-r96bp 1/1 Running 0 3m55s
rancher-monitoring-prometheus-adapter-55dc9ccd5d-vtssc 1/1 Running 0 3m55s
rancher-monitoring-prometheus-node-exporter-lgb88 1/1 Running 0 3m55s
rancher-monitoring-crd ManagedChart 狀態為 Modified
問題描述
在某些情況下,rancher-monitoring-crd ManagedChart 物件的狀態會變更為 Modified(訊息為 ...rancher-monitoring-crd-manager missing...)。
範例:
$ kubectl get managedchart rancher-monitoring-crd -n fleet-local -o yaml
apiVersion: management.cattle.io/v3
kind: ManagedChart
...
spec:
  chart: rancher-monitoring-crd
  defaultNamespace: cattle-monitoring-system
  paused: false
  releaseName: rancher-monitoring-crd
  repoName: harvester-charts
  targets:
  - clusterName: local
    clusterSelector:
      matchExpressions:
      - key: provisioning.cattle.io/unmanaged-system-agent
        operator: DoesNotExist
  version: 102.0.0+up40.1.2
...
status:
  conditions:
  - lastUpdateTime: "2024-02-22T14:03:11Z"
    message: Modified(1) [Cluster fleet-local/local]; clusterrole.rbac.authorization.k8s.io
      rancher-monitoring-crd-manager missing; clusterrolebinding.rbac.authorization.k8s.io
      rancher-monitoring-crd-manager missing; configmap.v1 cattle-monitoring-system/rancher-monitoring-crd-manifest
      missing; serviceaccount.v1 cattle-monitoring-system/rancher-monitoring-crd-manager
      missing
    status: "False"
    type: Ready
  - lastUpdateTime: "2024-02-22T14:03:11Z"
    status: "True"
    type: Processed
  - lastUpdateTime: "2024-04-02T07:45:26Z"
    status: "True"
    type: Defined
  display:
    readyClusters: 0/1
    state: Modified
...
ManagedChart 物件有一個名為 Bundle 的下游物件,其中包含類似資訊。
範例:
$ kubectl get bundles -A
NAMESPACE     NAME                                          BUNDLEDEPLOYMENTS-READY   STATUS
fleet-local   fleet-agent-local                             1/1
fleet-local   local-managed-system-agent                    1/1
fleet-local   mcc-harvester                                 1/1
fleet-local   mcc-harvester-crd                             1/1
fleet-local   mcc-local-managed-system-upgrade-controller   1/1
fleet-local   mcc-rancher-logging-crd                       1/1
fleet-local   mcc-rancher-monitoring-crd                    0/1                       Modified(1) [Cluster fleet-local/local]; clusterrole.rbac.authorization.k8s.io rancher-monitoring-crd-manager missing; clusterrolebinding.rbac.authorization.k8s.io rancher-monitoring-crd-manager missing; configmap.v1 cattle-monitoring-system/rancher-monitoring-crd-manifest missing; serviceaccount.v1 cattle-monitoring-system/rancher-monitoring-crd-manager missing
當存在此問題且您開始升級時,Harvester 可能會回傳以下錯誤訊息:admission webhook "validator.harvesterhci.io" denied the request: managed chart rancher-monitoring-crd is not ready, please wait for it to be ready。
此外,當您搜尋標記為 missing 的物件時,您會發現它們存在於叢集中。
範例:
$ kubectl get clusterrole rancher-monitoring-crd-manager
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
  annotations:
    meta.helm.sh/release-name: rancher-monitoring-crd
    meta.helm.sh/release-namespace: cattle-monitoring-system
  creationTimestamp: "2023-01-09T11:04:33Z"
  labels:
    app: rancher-monitoring-crd-manager
    app.kubernetes.io/managed-by: Helm
  name: rancher-monitoring-crd-manager
  ...
rules:
- apiGroups:
  - apiextensions.k8s.io
  resources:
  - customresourcedefinitions
  verbs:
  - create
  - get
  - patch
  - delete

$ kubectl get clusterrolebinding rancher-monitoring-crd-manager
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRoleBinding
metadata:
  annotations:
    meta.helm.sh/release-name: rancher-monitoring-crd
    meta.helm.sh/release-namespace: cattle-monitoring-system
  creationTimestamp: "2023-01-09T11:04:33Z"
  labels:
    app: rancher-monitoring-crd-manager
    app.kubernetes.io/managed-by: Helm
  name: rancher-monitoring-crd-manager
  ...
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: ClusterRole
  name: rancher-monitoring-crd-manager
subjects:
- kind: ServiceAccount
  name: rancher-monitoring-crd-manager
  namespace: cattle-monitoring-system

$ kubectl get configmap -n cattle-monitoring-system rancher-monitoring-crd-manifest
apiVersion: v1
data:
  crd-manifest.tgz.b64: ...
kind: ConfigMap
metadata:
  annotations:
    meta.helm.sh/release-name: rancher-monitoring-crd
    meta.helm.sh/release-namespace: cattle-monitoring-system
  creationTimestamp: "2023-01-09T11:04:33Z"
  labels:
    app.kubernetes.io/managed-by: Helm
  name: rancher-monitoring-crd-manifest
  namespace: cattle-monitoring-system
  ...

$ kubectl get ServiceAccount -n cattle-monitoring-system rancher-monitoring-crd-manager
apiVersion: v1
kind: ServiceAccount
metadata:
  annotations:
    meta.helm.sh/release-name: rancher-monitoring-crd
    meta.helm.sh/release-namespace: cattle-monitoring-system
  creationTimestamp: "2023-01-09T11:04:33Z"
  labels:
    app: rancher-monitoring-crd-manager
    app.kubernetes.io/managed-by: Helm
  name: rancher-monitoring-crd-manager
  namespace: cattle-monitoring-system
  ...
根本原因
標記為 missing 的物件沒有 ManagedChart 物件所需的相關註解和標籤。
範例:
其中一個手動重新建立的物件:

apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRole
metadata:
  annotations:
    meta.helm.sh/release-name: rancher-monitoring-crd
    meta.helm.sh/release-namespace: cattle-monitoring-system
    objectset.rio.cattle.io/id: default-mcc-rancher-monitoring-crd-cattle-fleet-local-system   # 上述物件中缺少此必要項目。
  creationTimestamp: "2024-04-03T10:23:55Z"
  labels:
    app: rancher-monitoring-crd-manager
    app.kubernetes.io/managed-by: Helm
    objectset.rio.cattle.io/hash: 2da503261617e9ea2da822d2da7cdcfccad847a9    # 上述物件中缺少此必要項目。
  name: rancher-monitoring-crd-manager
...
rules:
- apiGroups:
  - apiextensions.k8s.io
  resources:
  - customresourcedefinitions
  verbs:
  - create
  - get
  - patch
  - delete
  - update
解決方法
-
修補 ClusterRole 物件
rancher-monitoring-crd-manager以新增update操作。$ cat > patchrules.yaml << EOF
rules:
- apiGroups:
- apiextensions.k8s.io
resources:
- customresourcedefinitions
verbs:
- create
- get
- patch
- delete
- update
EOF
$ kubectl patch ClusterRole rancher-monitoring-crd-manager --patch-file ./patchrules.yaml --type merge
$ rm ./patchrules.yaml -
修補標記為
missing的物件以新增所需的註解和標籤。$ cat > patchhash.yaml << EOF
metadata:
annotations:
objectset.rio.cattle.io/id: default-mcc-rancher-monitoring-crd-cattle-fleet-local-system
labels:
objectset.rio.cattle.io/hash: 2da503261617e9ea2da822d2da7cdcfccad847a9
EOF
$ kubectl patch ClusterRole rancher-monitoring-crd-manager --patch-file ./patchhash.yaml --type merge
$ kubectl patch ClusterRoleBinding rancher-monitoring-crd-manager --patch-file ./patchhash.yaml --type merge
$ kubectl patch ServiceAccount rancher-monitoring-crd-manager -n cattle-monitoring-system --patch-file ./patchhash.yaml --type merge
$ kubectl patch ConfigMap rancher-monitoring-crd-manifest -n cattle-monitoring-system --patch-file ./patchhash.yaml --type merge
$ rm ./patchhash.yaml -
檢查
rancher-monitoring-crdManagedChart 物件。幾秒鐘後,
rancher-monitoring-crdManagedChart 物件的狀態會變更為Ready。$ kubectl get managedchart -n fleet-local rancher-monitoring-crd -oyaml
apiVersion: management.cattle.io/v3
kind: ManagedChart
metadata:
...
name: rancher-monitoring-crd
namespace: fleet-local
...
status:
conditions:
- lastUpdateTime: "2024-04-22T21:41:44Z"
status: "True"
type: Ready
...此外,下游物件不再顯示錯誤指示器。
$ kubectl bundle -A
NAMESPACE     NAME                                          BUNDLEDEPLOYMENTS-READY   STATUS
fleet-local   fleet-agent-local                             1/1
fleet-local   local-managed-system-agent                    1/1
fleet-local   mcc-harvester                                 1/1
fleet-local   mcc-harvester-crd                             1/1
fleet-local   mcc-local-managed-system-upgrade-controller   1/1
fleet-local   mcc-rancher-logging-crd                       1/1
fleet-local mcc-rancher-monitoring-crd 1/1 -
(選用)重試升級(如果先前因此問題而未成功)。
相關問題
https://github.com/harvester/harvester/issues/5505
某些 rancher-monitoring 附加元件 Pod 突然終止
問題描述
當啟用 rancher-monitoring 附加元件時,與 Prometheus、Alertmanager 和 Grafana 相關的 Pod 在建立後不久就會終止。
範例:
$ kubectl -n cattle-monitoring-system get pods,svc,ep,deploy,pvc,sts,prometheus,alertmanager | grep -E 'stateful|deploy'

deployment.apps/rancher-monitoring-grafana              0/0     0            0           7h52m
deployment.apps/rancher-monitoring-kube-state-metrics   1/1     1            1           7h52m
deployment.apps/rancher-monitoring-operator             1/1     1            1           7h52m
deployment.apps/rancher-monitoring-prometheus-adapter   1/1     1            1           7h52m
statefulset.apps/alertmanager-rancher-monitoring-alertmanager   0/0     7h52m
statefulset.apps/prometheus-rancher-monitoring-prometheus       0/0     7h52m
prometheus Pod 日誌包含訊息 level=warn msg="Received SIGTERM, exiting gracefully..."。
prometheus pod 的日誌:

...
ts=2025-05-20T05:41:02.847Z caller=kubernetes.go:327 level=info component="discovery manager notify" discovery=kubernetes config=config-0 msg="Using pod service account via in-cluster config"
ts=2025-05-20T05:41:02.880Z caller=main.go:1261 level=info msg="Completed loading of configuration file" filename=/etc/prometheus/config_out/prometheus.env.yaml totalDuration=35.457401ms db_storage=998ns remote_storage=1.45µs web_handler=392ns query_engine=1.095µs scrape=34.384µs scrape_sd=515.81µs notify=10.226µs notify_sd=82.314µs rules=32.514863ms tracing=2.344µs
ts=2025-05-20T05:41:50.044Z caller=main.go:854 level=warn msg="Received SIGTERM, exiting gracefully..."
ts=2025-05-20T05:41:50.044Z caller=main.go:878 level=info msg="Stopping scrape discovery manager..."
ts=2025-05-20T05:41:50.044Z caller=main.go:892 level=info msg="Stopping notify discovery manager..."
...
prometheus CRD 物件包含 storage-network.settings.harvesterhci.io/replica: "1" 註解。
- apiVersion: monitoring.coreos.com/v1
  kind: Prometheus
  metadata:
    annotations:
      meta.helm.sh/release-name: rancher-monitoring
      meta.helm.sh/release-namespace: cattle-monitoring-system
      storage-network.settings.harvesterhci.io/replica: "1"
    creationTimestamp: "2025-05-20T06:40:25Z"
Harvester Pod 日誌('harvester-system/harvester' 部署)指出嘗試變更 storage-network 設定被阻止。
...
2025-05-20T08:13:49.842448311Z time="2025-05-20T08:13:49Z" level=info msg="storage network change: {\"vlan\":955,\"clusterNetwork\":\"k8s-storage\",\"range\":\"198.18.2.0/24\"}"
2025-05-20T08:13:49.842476305Z time="2025-05-20T08:13:49Z" level=info msg="rancher monitoring not found. skip"
2025-05-20T08:13:49.842479072Z time="2025-05-20T08:13:49Z" level=info msg="current Grafana replicas: 0"
2025-05-20T08:13:49.842480501Z time="2025-05-20T08:13:49Z" level=info msg="VM import controller no found. skip"
2025-05-20T08:13:49.851381877Z time="2025-05-20T08:13:49Z" level=error msg="error syncing 'storage-network': handler harvester-storage-network-controller: Waiting for all volumes detached: pvc-6f66d234-f9c2-453e-8c17-383d9b489956,pvc-07c626f5-5135-4783-952d-cc20b1607cb5,pvc-1cfd6efe-c928-42e5-a834-8c27ed0e4897,pvc-5ce98d0a-5da1-4f30-af14-a8de29233380,pvc-1c9b7c9a-4943-4462-9082-217f9988cfc5,pvc-e9d92bfd-63c7-4ae3-ba00-1ce209f12caa,pvc-205ba31d-35fb-44f6-a3c4-c53001ec0dd6,pvc-6b5a7d11-7578-4397-9e13-ab475fe91463,pvc-669c69dd-93ad-4304-a340-484f7108362b,pvc-7668c486-b688-4524-b359-0cf9ec21cbc0,pvc-7d294996-821f-4434-ae4f-55a6de67f28c,pvc-216333c6-73f9-4e68-ac8b-53ab95a1f138,pvc-f72ca889-70c9-4dd9-bcec-a17ab65a1df4,pvc-01895fab-12f8-452a-9161-7d3c01e22726,pvc-330caa2d-5fdc-42f2-8c53-c5f80044760f,pvc-9506b7d0-c2d5-41f2-a08b-d7bc22dddb88,pvc-3e2b46d4-c471-44a9-9765-64babdb6ceed,pvc-25fe3372-1802-46d5-abf1-039099c567e2,pvc-b16fb262-cb38-4438-b074-84c7ad080a15,pvc-757c0f22-4ed6-4669-844d-cd7a87ceb26e,pvc-e0d99d8f-581f-4be6-baa3-d345308c9330,pvc-f5e1e19d-3dfb-4be1-9354-c092d7f03009,pvc-383ec26a-51f6-4f9d-8d8a-179651846d92,pvc-0d8f5737-c6e4-4f55-8d19-cf7a785552fc,pvc-5091892e-faf2-47b1-b987-bbde1ab2c13a,pvc-6f0c97ae-dfda-4799-bf26-e85feace5414,pvc-b0f717af-8a79-4c4e-b82e-90dedeae7697,pvc-ffe982d5-5ff1-40aa-a0db-cc10360d2d89,pvc-370757e2-4bce-41e7-b6f7-95aa8a5e8cf1,pvc-5a77d3e3-d555-476c-840f-7b9dadeb7478,pvc-43987c88-99b1-4889-9a47-5261717fe265,pvc-9f675704-9c52-46c2-96bf-2ff83d805383,pvc-d0b4e1d0-9bcd-4a8a-b52c-e1d8062a8099,pvc-a29be31f-531f-409a-bf5a-d267a54e2edb, requeuing"
...
根本原因
當您變更 storage-network 設定時,Harvester 控制器會在套用變更之前等待附加的儲存區分離。此外,控制器會自動終止與 Prometheus、Alertmanager 和 Grafana 相關的 Pod,因為這些 Pod 使用儲存區來儲存資料。
此程序通常需要很短的時間才能完成,但在發生以下情況時可能會中斷:
- 附加的儲存區阻止 Harvester 控制器將變更套用到設定。
- 使用者或
monitoring-operator嘗試啟用rancher-monitoring附加元件。 - Harvester 控制器終止 Pod。
解決方法
-
停用
rancher-monitoring附加元件。 -
檢查 storage-network 設定是啟用還是停用。
-
檢查 Harvester Pod 日誌中的錯誤指示器。如果儲存區仍然附加,請停止相關虛擬機,直到
storage network change訊息後不再出現錯誤。 -
啟用
rancher-monitoring附加元件。