從 v1.4.1/v1.4.2 升級到 v1.4.3
一般資訊
每當有可供升級的新 Harvester 版本時,Dashboard 畫面上就會出現 Upgrade 按鈕。如需更多資訊,請參閱開始升級。
Harvester v1.4.2 和 v1.4.3 使用相同的 RKE2 次要版本(v1.31)。這使得可以直接從 Harvester v1.4.1 升級到 v1.4.3,而無需先升級到 v1.4.2。
對於離線環境,請參閱準備離線升級。
已知問題
1. 離線升級因 Fluentd 和 Fluent Bit Pod 的 ImagePullBackOff 錯誤而卡住
升級可能會在過程的一開始就卡住,如 Harvester UI 的 Upgrade 對話框中顯示的 0% 進度和標記為 Pending 的項目所示。
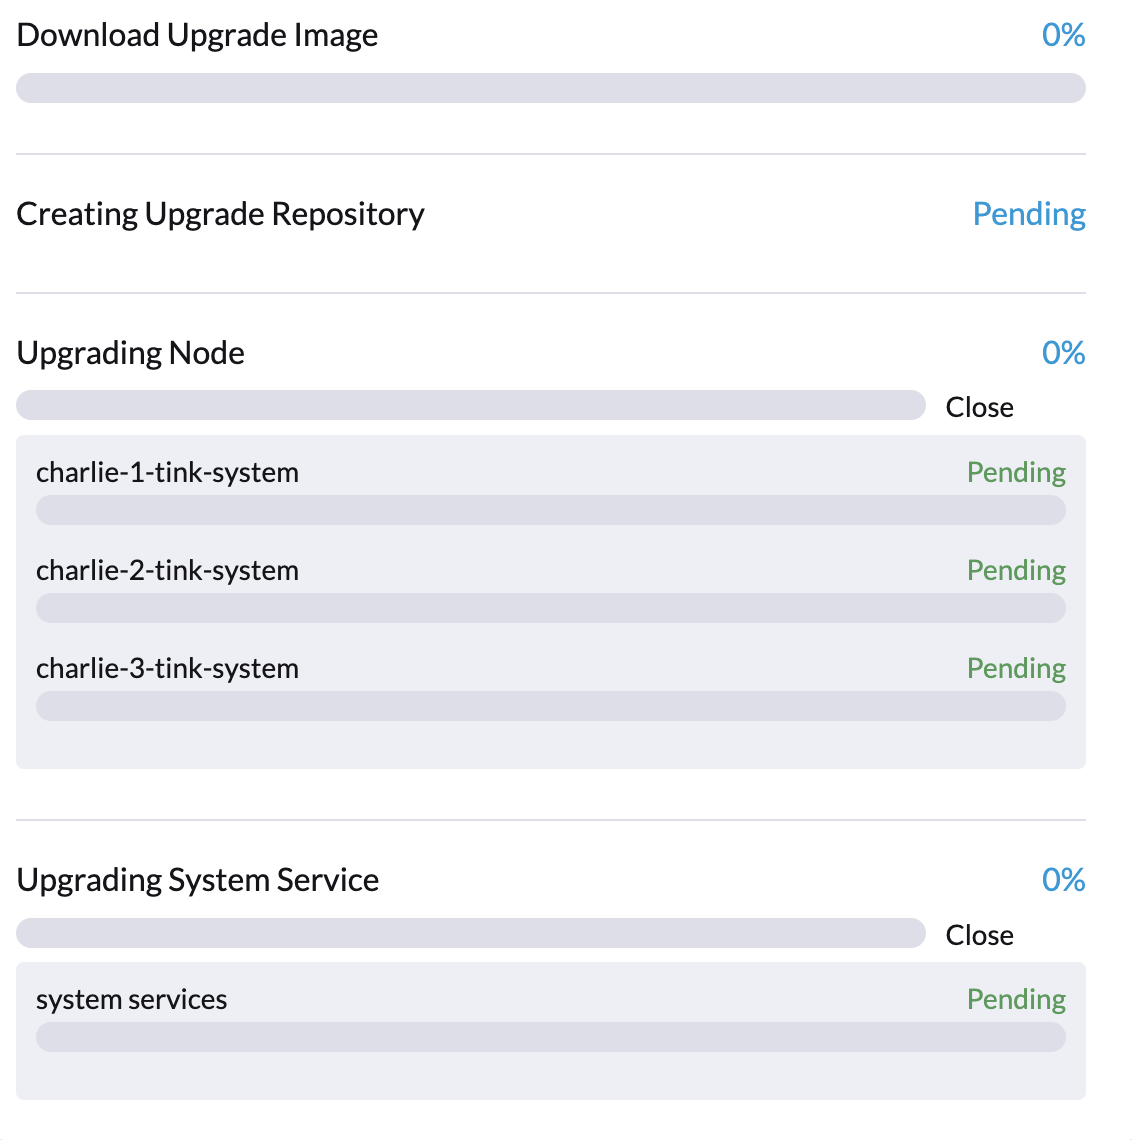
具體來說,Fluentd 和 Fluent Bit Pod 可能會卡在 ImagePullBackOff 狀態。要檢查 Pod 的狀態,請執行以下命令:
$ kubectl -n harvester-system get upgrades -l harvesterhci.io/latestUpgrade=true
NAME                 AGE
hvst-upgrade-x2hz8   7m14s

$ kubectl -n harvester-system get upgradelogs -l harvesterhci.io/upgrade=hvst-upgrade-x2hz8
NAME                            UPGRADE
hvst-upgrade-x2hz8-upgradelog   hvst-upgrade-x2hz8

$ kubectl -n harvester-system get pods -l harvesterhci.io/upgradeLog=hvst-upgrade-x2hz8-upgradelog
NAME                                                        READY   STATUS             RESTARTS   AGE
hvst-upgrade-x2hz8-upgradelog-downloader-6cdb864dd9-6bw98   1/1     Running            0          7m7s
hvst-upgrade-x2hz8-upgradelog-infra-fluentbit-2nq7q         0/1     ImagePullBackOff   0          7m42s
hvst-upgrade-x2hz8-upgradelog-infra-fluentbit-697wf         0/1     ImagePullBackOff   0          7m42s
hvst-upgrade-x2hz8-upgradelog-infra-fluentbit-kd8kl         0/1     ImagePullBackOff   0          7m42s
hvst-upgrade-x2hz8-upgradelog-infra-fluentd-0               0/2     ImagePullBackOff   0          7m42s
這是因為以下容器映像檔既未在叢集節點中預載,也未從網際網路拉取:
ghcr.io/kube-logging/fluentd:v1.15-ruby3ghcr.io/kube-logging/config-reloader:v0.0.5fluent/fluent-bit:2.1.8
要修復此問題,請執行以下任一操作:
-
更新 Logging CR 以使用已在叢集節點中預載的映像檔。要執行此操作,請對叢集執行以下命令:
# Get the Logging CR names
OPERATOR_LOGGING_NAME=$(kubectl get loggings -l app.kubernetes.io/name=rancher-logging -o jsonpath="{.items[0].metadata.name}")
INFRA_LOGGING_NAME=$(kubectl get loggings -l harvesterhci.io/upgradeLogComponent=infra -o jsonpath="{.items[0].metadata.name}")

# Gather image info from operator's Logging CR
FLUENTD_IMAGE_REPO=$(kubectl get loggings $OPERATOR_LOGGING_NAME -o jsonpath="{.spec.fluentd.image.repository}")
FLUENTD_IMAGE_TAG=$(kubectl get loggings $OPERATOR_LOGGING_NAME -o jsonpath="{.spec.fluentd.image.tag}")

FLUENTBIT_IMAGE_REPO=$(kubectl get loggings $OPERATOR_LOGGING_NAME -o jsonpath="{.spec.fluentbit.image.repository}")
FLUENTBIT_IMAGE_TAG=$(kubectl get loggings $OPERATOR_LOGGING_NAME -o jsonpath="{.spec.fluentbit.image.tag}")

CONFIG_RELOADER_IMAGE_REPO=$(kubectl get loggings $OPERATOR_LOGGING_NAME -o jsonpath="{.spec.fluentd.configReloaderImage.repository}")
CONFIG_RELOADER_IMAGE_TAG=$(kubectl get loggings $OPERATOR_LOGGING_NAME -o jsonpath="{.spec.fluentd.configReloaderImage.tag}")

# Patch the Logging CR
kubectl patch logging $INFRA_LOGGING_NAME --type=json -p="[{\"op\":\"replace\",\"path\":\"/spec/fluentbit/image\",\"value\":{\"repository\":\"$FLUENTBIT_IMAGE_REPO\",\"tag\":\"$FLUENTBIT_IMAGE_TAG\"}}]"
kubectl patch logging $INFRA_LOGGING_NAME --type=json -p="[{\"op\":\"replace\",\"path\":\"/spec/fluentd/image\",\"value\":{\"repository\":\"$FLUENTD_IMAGE_REPO\",\"tag\":\"$FLUENTD_IMAGE_TAG\"}}]"
kubectl patch logging $INFRA_LOGGING_NAME --type=json -p="[{\"op\":\"replace\",\"path\":\"/spec/fluentd/configReloaderImage\",\"value\":{\"repository\":\"$CONFIG_RELOADER_IMAGE_REPO\",\"tag\":\"$CONFIG_RELOADER_IMAGE_TAG\"}}]"
Logging CR 更新後,Fluentd 和 Fluent Bit Pod 的狀態應該會立即變為
Running,升級過程應該會繼續。如果 Fluentd Pod 仍處於ImagePullBackOff狀態,請嘗試使用以下命令刪除它以強制重新啟動:UPGRADE_NAME=$(kubectl -n harvester-system get upgrades -l harvesterhci.io/latestUpgrade=true -o jsonpath='{.items[0].metadata.name}')
UPGRADELOG_NAME=$(kubectl -n harvester-system get upgradelogs -l harvesterhci.io/upgrade=$UPGRADE_NAME -o jsonpath='{.items[0].metadata.name}')
kubectl -n harvester-system delete pods -l harvesterhci.io/upgradeLog=$UPGRADELOG_NAME,harvesterhci.io/upgradeLogComponent=aggregator -
在可以存取網際網路的電腦上,拉取所需的容器映像檔,然後將它們匯出到 TAR 檔案。接下來,將 TAR 檔案傳輸到叢集節點,然後透過在每個節點上執行以下命令匯入映像檔:
# Pull down the three container images
docker pull ghcr.io/kube-logging/fluentd:v1.15-ruby3
docker pull ghcr.io/kube-logging/config-reloader:v0.0.5
docker pull fluent/fluent-bit:2.1.8

# Export the images to a tar file
docker save \
  ghcr.io/kube-logging/fluentd:v1.15-ruby3 \
  ghcr.io/kube-logging/config-reloader:v0.0.5 \
  fluent/fluent-bit:2.1.8 > upgradelog-images.tar

# After transferring the tar file to the cluster nodes, import the images (need to be run on each node)
ctr -n k8s.io images import upgradelog-images.tar
映像檔預載後,升級過程應該會繼續。
-
(不建議)在停用日誌記錄的情況下重新啟動升級過程。確保未選中 Upgrade 對話框中的 Enable Logging 核取方塊。
相關 issue:#7955
2. 超大卷
在使用 Longhorn v1.7.3 的 Harvester v1.4.3 中,超大卷(例如大小為 999999 Gi)會標記為 Not Ready 且無法刪除。
要解決此問題,請執行以下步驟:
-
暫時移除 PVC webhook 規則。
RULE_INDEX=$(kubectl get \
  validatingwebhookconfiguration longhorn-webhook-validator -o json \
  | jq '.webhooks[0].rules | map(.resources[0] == "persistentvolumeclaims") | index(true)')

if [ -n "$RULE_INDEX" -a "$RULE_INDEX" != "null" ]; then
  kubectl patch validatingwebhookconfiguration longhorn-webhook-validator \
    --type='json' \
    -p="[{'op': 'remove', 'path': '/webhooks/0/rules/$RULE_INDEX'}]"
fi -
等待相關 PVC 被刪除。
-
恢復 PVC webhook 規則以重新啟用驗證。
kubectl patch validatingwebhookconfiguration longhorn-webhook-validator \
  --type='json' \
  -p='[{"op": "add", "path": "/webhooks/0/rules/-", "value": {"apiGroups":[""],"apiVersions":["v1"],"operations":["UPDATE"],"resources":["persistentvolumeclaims"],"scope":"Namespaced"}}]'
此問題將在 Longhorn v1.8.2 中解決,該版本可能會包含在 Harvester v1.5.1 中。
3. 訪客叢集上的非 root 使用者無法存取 RWX 卷
訪客叢集上的非 root 使用者在存取 RWX 卷時會遇到意外的「Permission denied」錯誤。這是由 nfs-ganesha v6.0+ 中的回歸問題引起的,影響 longhorn-share-manager 映像檔的 v1.7.3 版本。
您可以透過將 longhorn-share-manager:v1.7.3 替換為修補後的映像檔 longhorn-share-manager:v1.7.3-hotfix-1 來解決此問題。
- 透過執行以下命令編輯
longhorn-managerDaemonSet:
kubectl -n longhorn-system edit daemonset/longhorn-manager
- 在
spec.containers.command欄位中,將--share-manager-image更改為longhornio/longhorn-share-manager:v1.7.3-hotfix-1。
...
  spec:
    containers:
    - command:
      - longhorn-manager
      - -d
      - daemon
      - --engine-image
      - longhornio/longhorn-engine:v1.7.3
      - --instance-manager-image
      - longhornio/longhorn-instance-manager:v1.7.3
      - --share-manager-image
      - longhornio/longhorn-share-manager:v1.7.3-hotfix-1
      - --backing-image-manager-image
      - longhornio/backing-image-manager:v1.7.3
      - --support-bundle-manager-image
      - longhornio/support-bundle-kit:v0.0.51
      - --manager-image
      - longhornio/longhorn-manager:v1.7.3
      - --service-account
      - longhorn-service-account
      - --upgrade-version-check
...
- 套用更新後,重新啟動正在使用 RWX 卷的工作負載。
-
如果您未受此問題影響,請勿使用修補後的映像檔。
-
如果您正在使用修補後的映像檔並希望升級 Harvester v1.5.x,您必須在開始升級之前編輯
longhorn-managerDaemonSet 並還原到longhorn-share-manager:v1.7.3映像檔。
4. 使用可遷移 RWX 卷的虛擬機意外重新啟動
Longhorn 問題導致使用可遷移 RWX 卷的虛擬機在 CSI 外掛 Pod 重新啟動時意外重新啟動。此問題影響 Harvester v1.4.x、v1.5.0 和 v1.5.1。
解決方法是在開始升級之前在 Longhorn UI 上停用設定 Automatically Delete Workload Pod When The Volume Is Detached Unexpectedly。升級完成後,您必須再次啟用該設定。
此問題將在 Longhorn v1.8.3、v1.9.1 及更高版本中修復。Harvester v1.6.0 將包含 Longhorn v1.9.1。