從 v1.1.2 升級到 v1.2.0(不建議)
由於 v1.2.0 中發現的已知問題:
我們不建議升級到 v1.2.0。請將您的 v1.1.x 叢集升級到 v1.2.1。
一般資訊
在開始升級之前,您可以執行預檢查腳本以確保叢集處於穩定狀態。如需更多詳細資訊,請造訪此 URL 以取得腳本。
一旦有可升級的版本,Harvester GUI Dashboard 頁面將顯示一個升級按鈕。如需更多詳細資訊,請參閱開始升級。
對於離線環境升級,請參閱準備離線升級。
已知問題
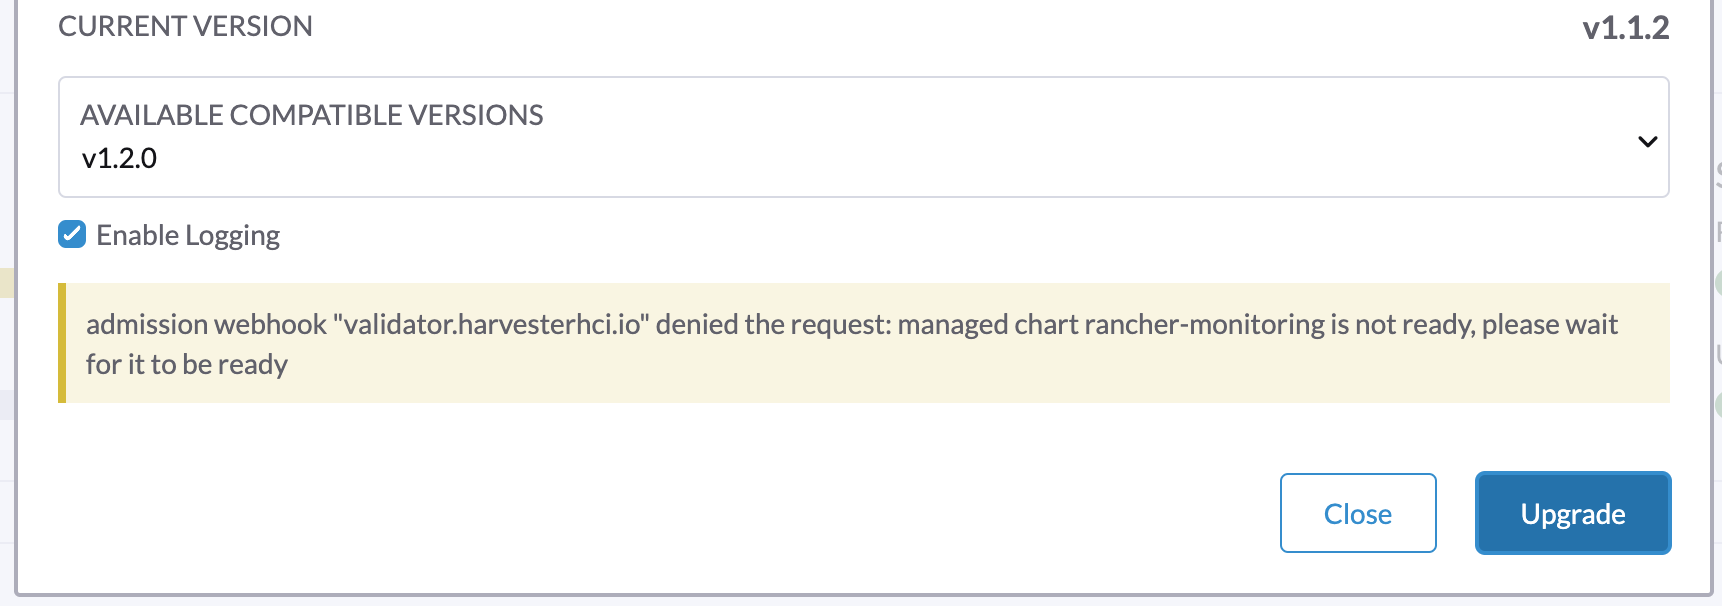
1. 升級無法開始並報告 "validator.harvesterhci.io" denied the request: managed chart rancher-monitoring is not ready, please wait for it to be ready
如果叢集配置了儲存網路,升級無法開始並顯示以下訊息。
- 相關 issue:
- 解決方法:
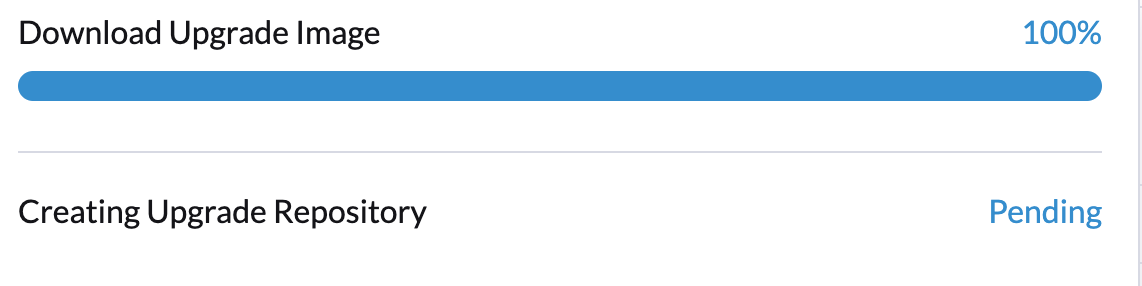
2. 升級卡在 Creating Upgrade Repository
在升級期間,Creating Upgrade Repository 卡在 Pending 狀態:
請執行以下步驟檢查叢集是否遇到此問題:
-
檢查升級儲存庫 Pod:
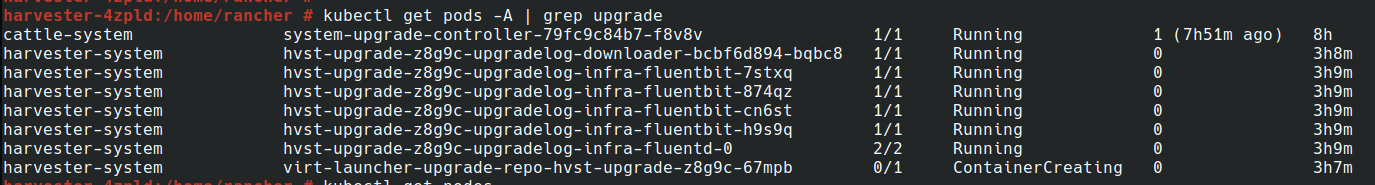
如果
virt-launcher-upgrade-repo-hvst-<upgrade-name>Pod 停留在ContainerCreating,您的叢集可能遇到此問題。在這種情況下,請繼續執行步驟 2。 -
在 Longhorn GUI 中檢查升級儲存庫卷。
- 前往 Longhorn GUI。
- 導航到 Volume 頁面。
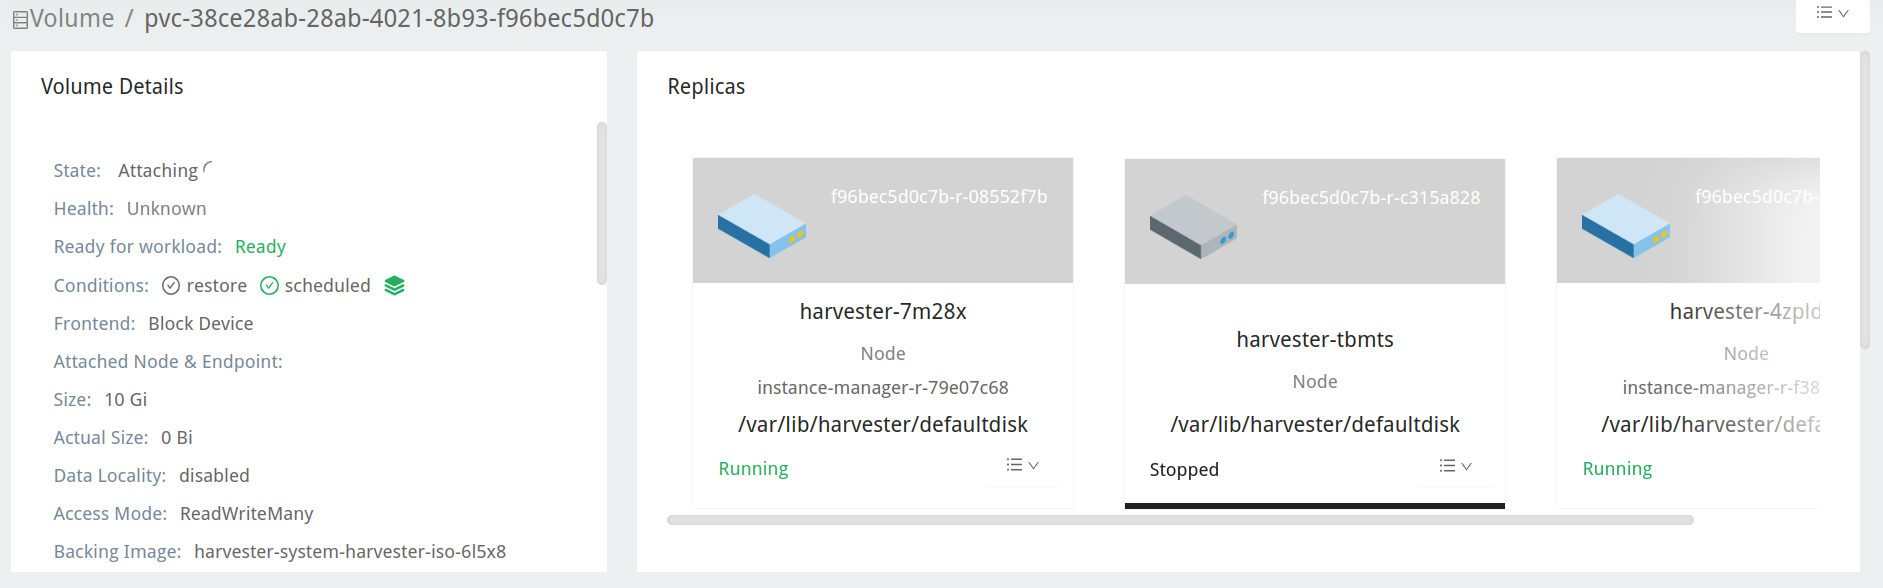
- 檢查升級儲存庫 VM 卷。它應該連接到名為
virt-launcher-upgrade-repo-hvst-<upgrade-name>的 Pod。如果卷的其中一個副本停留在Stopped(灰色),則叢集正在遇到此問題。
- 相關 issue:
- 解決方法:
- 從 Longhorn GUI 刪除
Stopped副本。或者, - 重新啟動升級。
- 從 Longhorn GUI 刪除
3. 升級在預清空節點時卡住
從 v1.1.0 開始,Harvester 會在升級節點之前等待所有卷變得健康(當節點數量 >= 3 時)。一般來說,如果升級卡在「pre-draining」狀態,您可以檢查卷的健康狀況。
造訪「存取嵌入式 Longhorn」以了解如何存取嵌入式 Longhorn GUI。
您也可以檢查 pre-drain 任務日誌。請參閱故障排除指南中的 Phase 4: Upgrade nodes。
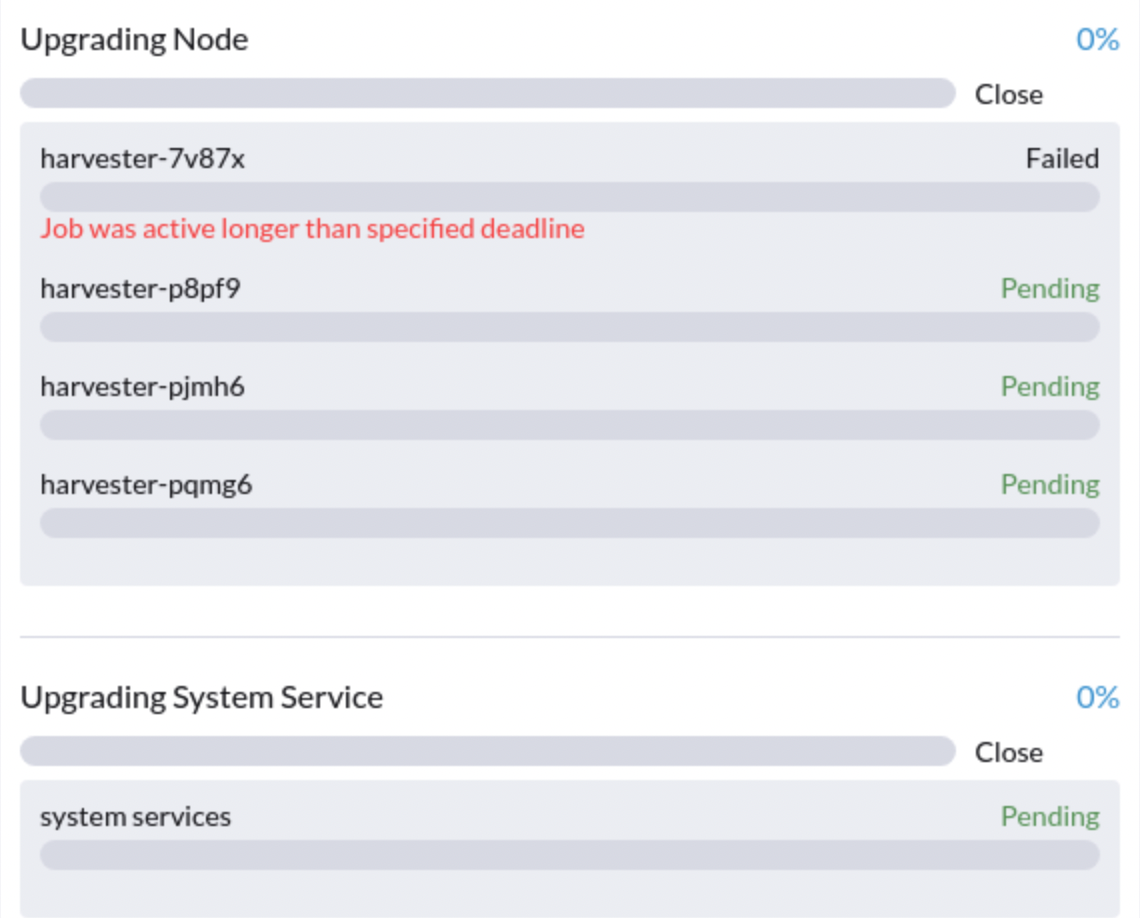
4. 升級卡在升級第一個節點:Job was active longer than the specified deadline
升級失敗,如下方螢幕截圖所示:
- 相關 issue:
- 解決方法:
5. 升級卡在 Pre-drained 狀態
您可能會看到升級卡在「pre-drained」狀態:
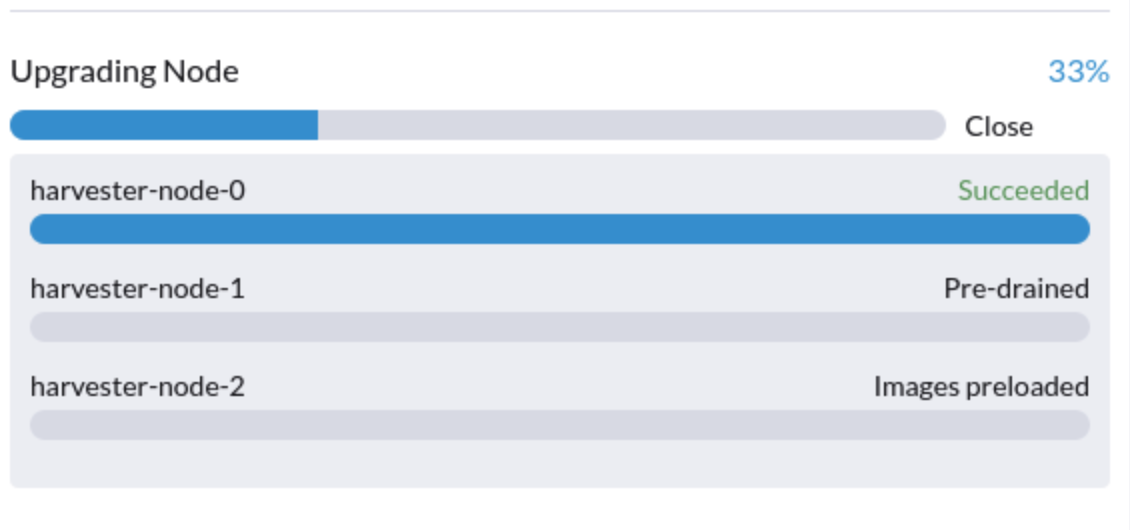
在此階段,Kubernetes 應該清空節點上的工作負載,但某些原因可能會導致過程停滯。
5.1 節點包含服務單副本卷的 Longhorn instance-manager-r Pod
如果節點包含卷的最後一個倖存副本,Longhorn 不允許清空節點。要檢查節點是否遇到這種情況,請按照以下步驟操作:
-
使用命令列出單副本卷:
kubectl get volumes.longhorn.io -A -o yaml | yq '.items[] | select(.spec.numberOfReplicas == 1) | .metadata.namespace + "/" + .metadata.name'例如:
$ kubectl get volumes.longhorn.io -A -o yaml | yq '.items[] | select(.spec.numberOfReplicas == 1) | .metadata.namespace + "/" + .metadata.name'
longhorn-system/pvc-d1f19bab-200e-483b-b348-c87cfbba85ab -
檢查副本是否駐留在卡住的節點上:
使用命令列出卷副本的 NodeID:
kubectl get replicas.longhorn.io -n longhorn-system -o yaml | yq '.items[] | select(.metadata.labels.longhornvolume == "<volume>") | .spec.nodeID'例如:
$ kubectl get replicas.longhorn.io -n longhorn-system -o yaml | yq '.items[] | select(.metadata.labels.longhornvolume == "pvc-d1f19bab-200e-483b-b348-c87cfbba85ab") | .spec.nodeID'
node1
如果結果顯示副本駐留在升級卡住的節點上(在此範例中為 node1),則您的叢集遇到此問題。
有幾種方法可以解決這種情況。為您的虛擬機選擇最合適的方法:
- 關閉使用單副本卷的虛擬機以分離卷,讓升級繼續。
- 將卷的副本調整為多於一個。
- 前往 Longhorn GUI。
- 前往 Volume 頁面。
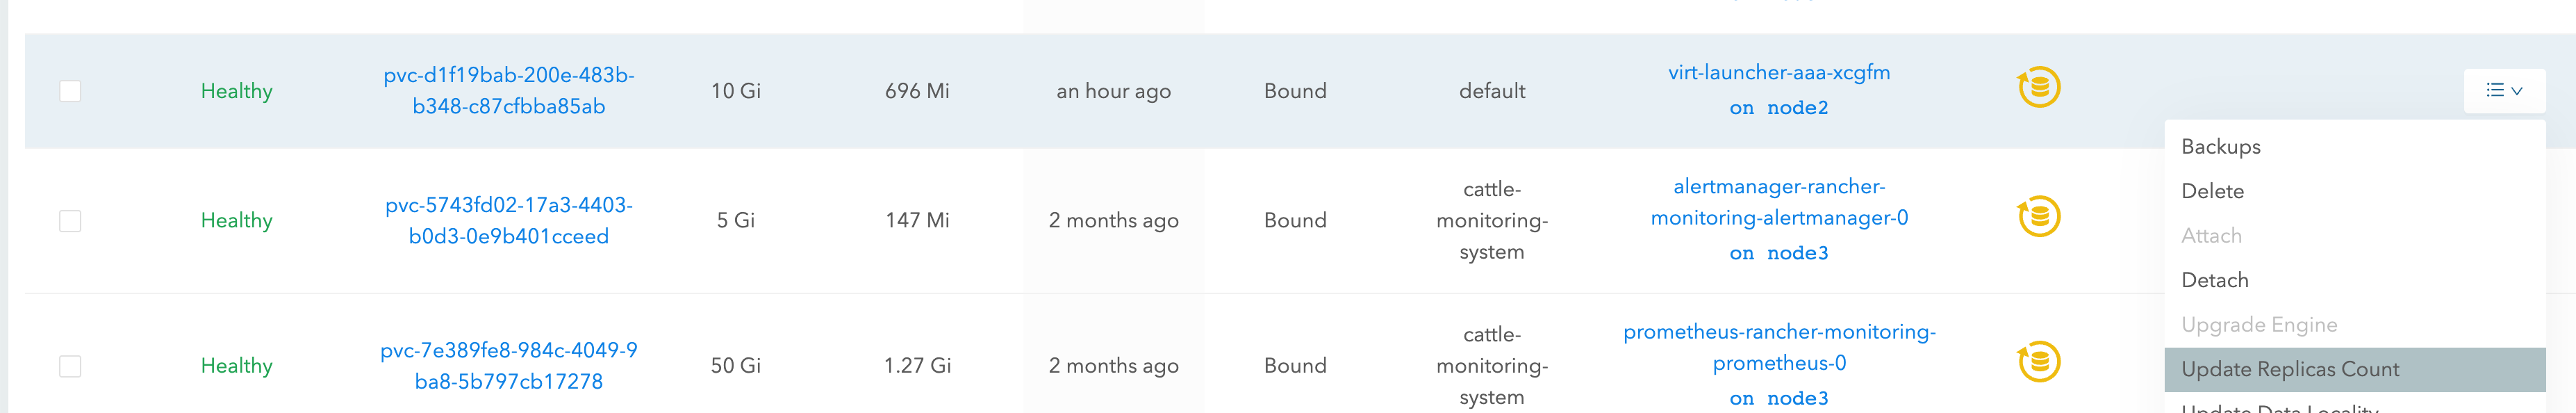
- 找到有問題的卷並點擊右側的圖示,然後選擇 Update Replicas Count:
- 增加 Number of Replicas 並選擇 OK。
5.2 配置錯誤的 Longhorn instance-manager-r Pod Disruption Budget(PDB)
配置錯誤的 PDB 可能會導致此問題。要檢查是否是這種情況,請執行以下步驟:
-
假設卡住的節點是
harvester-node-1。 -
檢查卡住節點上的
instance-manager-e或instance-manager-rPod 名稱:$ kubectl get pods -n longhorn-system --field-selector spec.nodeName=harvester-node-1 | grep instance-manager
instance-manager-r-d4ed2788 1/1 Running 0 3d8h上述輸出顯示
instance-manager-r-d4ed2788Pod 在節點上。 -
檢查 Rancher 日誌並驗證
instance-manager-e或instance-manager-rPod 無法被清空:$ kubectl logs deployment/rancher -n cattle-system
...
2023-03-28T17:10:52.199575910Z 2023/03/28 17:10:52 [INFO] [planner] rkecluster fleet-local/local: waiting: draining etcd node(s) custom-4f8cb698b24a,custom-a0f714579def
2023-03-28T17:10:55.034453029Z evicting pod longhorn-system/instance-manager-r-d4ed2788
2023-03-28T17:10:55.080933607Z error when evicting pods/"instance-manager-r-d4ed2788" -n "longhorn-system" (will retry after 5s): Cannot evict pod as it would violate the pod's disruption budget. -
執行命令檢查是否有與卡住節點相關聯的 PDB:
$ kubectl get pdb -n longhorn-system -o yaml | yq '.items[] | select(.spec.selector.matchLabels."longhorn.io/node"=="harvester-node-1") | .metadata.name'
instance-manager-r-466e3c7f -
檢查此 PDB 的 instance manager 的擁有者:
$ kubectl get instancemanager instance-manager-r-466e3c7f -n longhorn-system -o yaml | yq -e '.spec.nodeID'
harvester-node-2
如果輸出與卡住的節點不符(在此範例輸出中,
harvester-node-2與卡住的節點harvester-node-1不符),則我們可以得出結論此問題發生。 -
在應用解決方法之前,檢查所有卷是否健康:
kubectl get volumes -n longhorn-system -o yaml | yq '.items[] | select(.status.state == "attached")| .status.robustness'輸出應該都是
healthy。如果不是這種情況,您可能需要取消封鎖節點以使卷再次健康。 -
刪除配置錯誤的 PDB:
kubectl delete pdb instance-manager-r-466e3c7f -n longhorn-system
5.3 無法清空 instance-manager-e Pod
在升級期間,您可能會遇到無法清空 instance-manager-e Pod 的問題。當這種情況發生時,您將在 Rancher 日誌中看到類似以下所示的錯誤訊息:
$ kubectl logs deployment/rancher -n cattle-system | grep "evicting pod"
evicting pod longhorn-system/instance-manager-r-a06a43f3437ab4f643eea7053b915a80
evicting pod longhorn-system/instance-manager-e-452e87d2
error when evicting pods/"instance-manager-r-a06a43f3437ab4f643eea7053b915a80" -n "Longhorn-system" (will retry after 5s): Cannot evict pod as it would violate the pod's disruption budget.
error when evicting pods/"instance-manager-e-452e87d2" -n "longhorn-system" (will retry after 5s): Cannot evict pod as it would violate the pod's disruption budget.
檢查 instance-manager-e 以查看是否有任何引擎實例保留。
$ kubectl get instancemanager instance-manager-e-452e87d2 -n longhorn-system -o yaml | yq -e ".status.instances"
pvc-7b120d60-1577-4716-be5a-62348271025a-e-1cd53c57:
  spec:
    name: pvc-7b120d60-1577-4716-be5a-62348271025a-e-1cd53c57
  status:
    endpoint: ""
    errorMsg: ""
    listen: ""
    portEnd: 10001
    portStart: 10001
    resourceVersion: 0
    state: running
    type: ""
在此範例中,instance-manager-e-452e87d2 仍然有一個引擎實例,因此您無法清空 Pod。
您需要檢查引擎數量以查看是否有任何引擎數量是多餘的。每個 PVC 應該只有一個引擎。
# kubectl get engines -n longhorn-system -l longhornvolume=pvc-7b120d60-1577-4716-be5a-62348271025a
NAME                                                  STATE     NODE               INSTANCEMANAGER                                      IMAGE                               AGE
pvc-76120d60-1577-4716-be5a-62348271025a-e-08220662   running   harvester-qv4hd    instance-manager-e-625d715e2f2e7065d64339f9b31407c2  longhornio/longhorn-engine:v1.4.3   2d12h
pvc-7b120d60-1577-4716-be5a-62348271025a-e-lcd53c57   running   harvester-lhlkv    instance-manager-e-452e87d2                          longhornio/longhorn-engine:v1.4.3   4d10h
上述範例顯示同一個 PVC 存在兩個引擎,這是 Longhorn #6642 中的已知問題。要解決此問題,請刪除多餘的引擎以允許升級繼續。
要確定哪個引擎是正確的,請使用以下命令:
$ kubectl get volumes pvc-7b120d60-1577-4716-be5a-62348271025a -n longhorn-system
NAME                                      STATE     ROBUSTNESS  SCHEDULED SIZE        NODE            AGE
pvc-7b120d60-1577-4716-be5a-62348271025a  attached  healthy               42949672960 harvester-q4vhd 4d10h
在此範例中,卷 pvc-7b120d60-1577-4716-be5a-62348271025a 在節點 harvester-q4vhd 上處於活動狀態,表示未在此節點上執行的引擎是多餘的。
要使引擎變為非活動狀態並觸發 Longhorn 自動刪除它,請執行以下命令:
$ kubectl patch engine pvc-7b120d60-1577-4716-be5a-62348271025a-e-lcd53c57 -n longhorn-system --type='json' -p='[{"op": "replace", "path": "/spec/active", "value": false}]'
engine.longhorn.io/pvc-7b120d60-1577-4716-be5a-62348271025a-e-lcd53c57 patched
幾秒鐘後,您可以驗證引擎的狀態:
$ kubectl get engine -n longhorn-system|grep pvc-7b120d60-1577-4716-be5a-62348271025a
pvc-7b120d60-1577-4716-be5a-62348271025a-e-08220b62   running  harvester-q4vhd   instance-manager-e-625d715e2f2e7065d64339f9631407c2  longhornio/longhorn-engine:v1.4.3   2d13h
instance-manager-e Pod 現在應該成功清空,允許升級繼續。
6. 升級卡在 Upgrading System Service 狀態
如果您注意到升級長時間卡在 Upgrading System Service 狀態,您可能需要調查升級是否卡在 apply-manifests 階段。
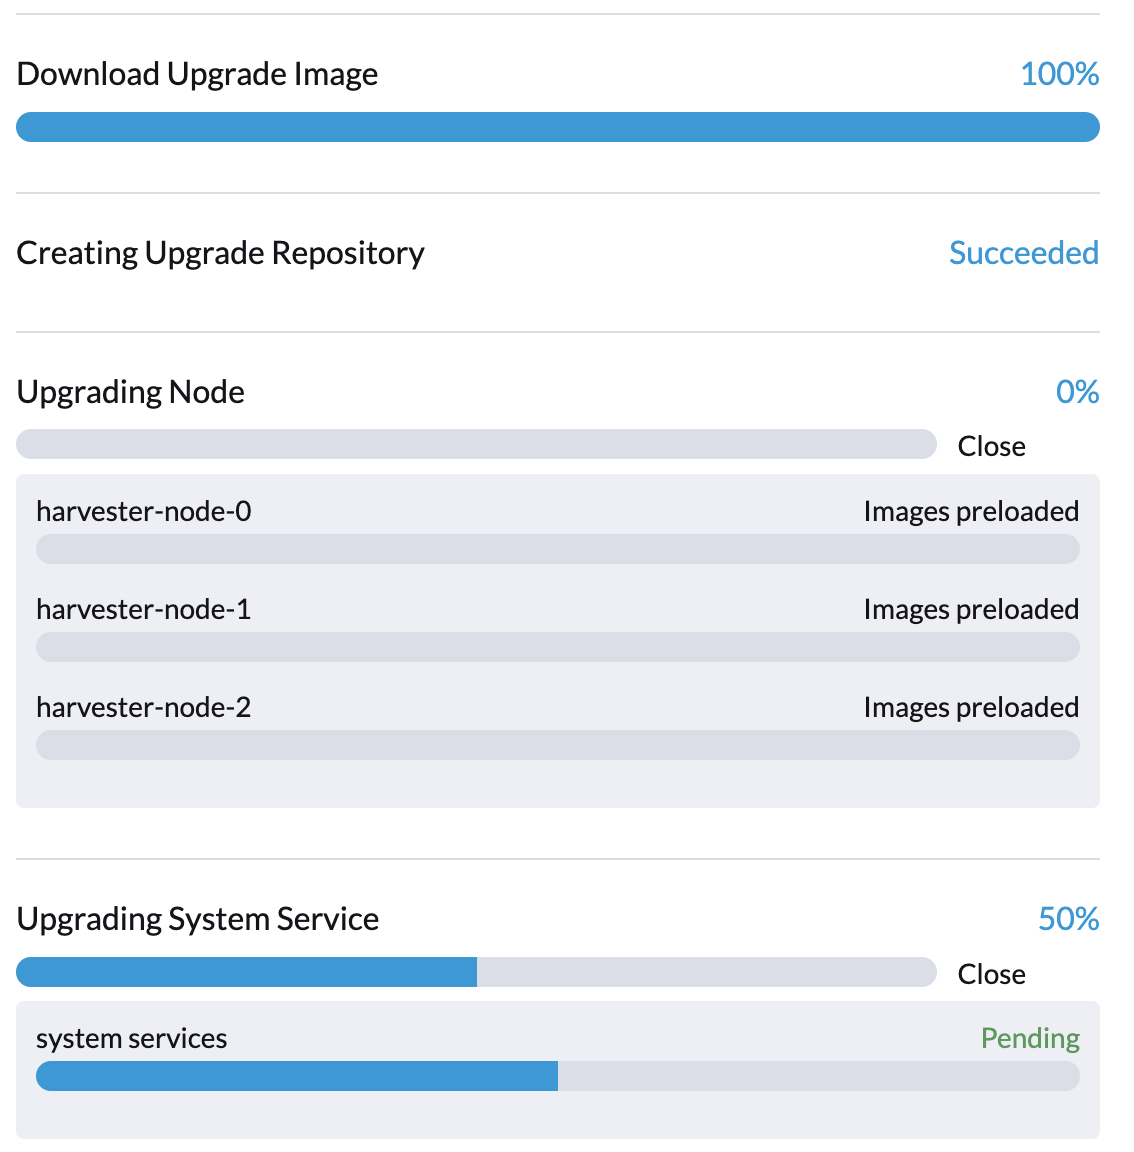
POD prometheus-rancher-monitoring-prometheus-0 待刪除
-
檢查
apply-manifestsPod 的日誌以查看以下訊息是否重複。$ kubectl -n harvester-system logs hvst-upgrade-md6wr-apply-manifests-wqslg --tail=10
Tue Sep 5 10:20:39 UTC 2023
there are still 1 pods in cattle-monitoring-system to be deleted
Tue Sep 5 10:20:45 UTC 2023
there are still 1 pods in cattle-monitoring-system to be deleted
Tue Sep 5 10:20:50 UTC 2023
there are still 1 pods in cattle-monitoring-system to be deleted
Tue Sep 5 10:20:55 UTC 2023
there are still 1 pods in cattle-monitoring-system to be deleted
Tue Sep 5 10:21:00 UTC 2023
there are still 1 pods in cattle-monitoring-system to be deleted -
檢查
prometheus-rancher-monitoring-prometheus-0Pod 是否卡在Terminating狀態。$ kubectl -n cattle-monitoring-system get pods
NAME READY STATUS RESTARTS AGE
prometheus-rancher-monitoring-prometheus-0 0/3 Terminating 0 19d -
使用以下命令找出終止中 Pod 的 UID:
$ kubectl -n cattle-monitoring-system get pod prometheus-rancher-monitoring-prometheus-0 -o jsonpath='{.metadata.uid}'
33f43165-6faa-4648-927d-69097901471c -
透過控制台或 SSH 存取叢集的任何節點。
-
使用 Pod 的 UID 在
/var/lib/rancher/rke2/agent/logs/kubelet.log中搜尋相關日誌訊息。E0905 10:26:18.769199 17399 reconciler.go:208] "operationExecutor.UnmountVolume failed (controllerAttachDetachEnabled true) for volume \"pvc-7781c988-c35b-4cf8-89e6-f2907ef33603\" (UniqueName: \"kubernetes.io/csi/driver.longhorn.io^pvc-7781c988-c35b-4cf8-89e6-f2907ef33603\") pod \"33f43165-6faa-4648-927d-69097901471c\" (UID: \"33f43165-6faa-4648-927d-69097901471c\") : UnmountVolume.NewUnmounter failed for volume \"pvc-7781c988-c35b-4cf8-89e6-f2907ef33603\" (UniqueName: \"kubernetes.io/csi/driver.longhorn.io^pvc-7781c988-c35b-4cf8-89e6-f2907ef33603\") pod \"33f43165-6faa-4648-927d-69097901471c\" (UID: \"33f43165-6faa-4648-927d-69097901471c\") : kubernetes.io/csi: unmounter failed to load volume data file [/var/lib/kubelet/pods/33f43165-6faa-4648-927d-69097901471c/volumes/kubernetes.io~csi/pvc-7781c988-c35b-4cf8-89e6-f2907ef33603/mount]: kubernetes.io/csi: failed to open volume data file [/var/lib/kubelet/pods/33f43165-6faa-4648-927d-69097901471c/volumes/kubernetes.io~csi/pvc-7781c988-c35b-4cf8-89e6-f2907ef33603/vol_data.json]: open /var/lib/kubelet/pods/33f43165-6faa-4648-927d-69097901471c/volumes/kubernetes.io~csi/pvc-7781c988-c35b-4cf8-89e6-f2907ef33603/vol_data.json: no such file or directory" err="UnmountVolume.NewUnmounter failed for volume \"pvc-7781c988-c35b-4cf8-89e6-f2907ef33603\" (UniqueName: \"kubernetes.io/csi/driver.longhorn.io^pvc-7781c988-c35b-4cf8-89e6-f2907ef33603\") pod \"33f43165-6faa-4648-927d-69097901471c\" (UID: \"33f43165-6faa-4648-927d-69097901471c\") : kubernetes.io/csi: unmounter failed to load volume data file [/var/lib/kubelet/pods/33f43165-6faa-4648-927d-69097901471c/volumes/kubernetes.io~csi/pvc-7781c988-c35b-4cf8-89e6-f2907ef33603/mount]: kubernetes.io/csi: failed to open volume data file [/var/lib/kubelet/pods/33f43165-6faa-4648-927d-69097901471c/volumes/kubernetes.io~csi/pvc-7781c988-c35b-4cf8-89e6-f2907ef33603/vol_data.json]: open /var/lib/kubelet/pods/33f43165-6faa-4648-927d-69097901471c/volumes/kubernetes.io~csi/pvc-7781c988-c35b-4cf8-89e6-f2907ef33603/vol_data.json: no such file or directory"如果 kubelet 繼續抱怨卷無法卸載,請應用以下解決方法以允許升級繼續。
-
使用以下命令強制刪除卡在
Terminating狀態的 Pod:kubectl delete pod prometheus-rancher-monitoring-prometheus-0 -n cattle-monitoring-system --force
cattle-monitoring-system 命名空間中的多個 POD 待刪除
-
檢查
apply-manifestsPod 的日誌以查看以下訊息是否重複。there are still 10 pods in cattle-monitoring-system to be deleted
Fri Dec 8 19:06:56 UTC 2023
there are still 10 pods in cattle-monitoring-system to be deleted
Fri Dec 8 19:07:01 UTC 2023當它持續顯示 10(或其他數字)個 Pod 時,它遇到以下問題。
監控功能是從 rancher-monitoring ManagedChart 部署的,在 Harvester v1.2.0、v1.2.1 中,
此 ManagedChart 在升級時轉換為 Harvester Addon 功能。
ManagedChart rancher-monitoring 被刪除,通常,所有產生的資源包括 deployment、
daemonset 等都會自動刪除。但在這種情況下,這些資源沒有被刪除。
上述日誌反映了結果。
以下說明將指導手動刪除它們。 -
找出
cattle-monitoring-system命名空間中受影響的資源。cattle-monitoring-system 中的根級別資源
自訂 CRD: Prometheus
Object: rancher-monitoring-prometheus
Sub-object: statefulset.apps/prometheus-rancher-monitoring-prometheus
自訂 CRD: Alertmanager
object: rancher-monitoring-alertmanager
Sub-object: statefulset.apps/alertmanager-rancher-monitoring-alertmanager
Deployment:
rancher-monitoring-grafana
rancher-monitoring-kube-state-metrics
rancher-monitoring-operator
rancher-monitoring-prometheus-adapter
Daemonset:
rancher-monitoring-prometheus-node-exporter -
刪除受影響的資源。
使用以下命令刪除它們,同時檢查 `apply-manifests` 的日誌,直到它不再
報告 `there are still x pods in cattle-monitoring-system to be deleted`。

kubectl delete prometheus rancher-monitoring-prometheus -n cattle-monitoring-system
kubectl delete alertmanager rancher-monitoring-alertmanager -n cattle-monitoring-system

kubectl delete deployment rancher-monitoring-grafana -n cattle-monitoring-system
kubectl delete deployment rancher-monitoring-kube-state-metrics -n cattle-monitoring-system
kubectl delete deployment rancher-monitoring-operator -n cattle-monitoring-system
kubectl delete deployment rancher-monitoring-prometheus-adapter -n cattle-monitoring-system

kubectl delete daemonset rancher-monitoring-prometheus-node-exporter -n cattle-monitoring-system備註您可能需要多次執行某些命令才能完全刪除資源。
7. 升級卡在 Upgrading System Service 狀態
如果升級長時間卡在 Upgrading System Service 狀態,某些系統服務的憑證可能已過期。要調查和解決此問題,請按照以下步驟操作:
-
使用命令找出
apply-manifest任務的名稱:kubectl get jobs -n harvester-system -l harvesterhci.io/upgradeComponent=manifest範例輸出:
NAME                                 COMPLETIONS   DURATION   AGE
hvst-upgrade-9gmg2-apply-manifests 0/1 46s 46s -
使用命令檢查任務的日誌:
kubectl logs jobs/hvst-upgrade-9gmg2-apply-manifests -n harvester-system如果日誌中出現以下訊息,請繼續下一步:
Waiting for CAPI cluster fleet-local/local to be provisioned (current phase: Provisioning, current generation: 30259)...
Waiting for CAPI cluster fleet-local/local to be provisioned (current phase: Provisioning, current generation: 30259)...
Waiting for CAPI cluster fleet-local/local to be provisioned (current phase: Provisioning, current generation: 30259)...
Waiting for CAPI cluster fleet-local/local to be provisioned (current phase: Provisioning, current generation: 30259)... -
使用命令檢查 CAPI 叢集的狀態:
kubectl get clusters.provisioning.cattle.io local -n fleet-local -o yaml如果您看到類似以下的條件,則叢集很可能遇到此問題:
    - lastUpdateTime: "2023-01-17T16:26:48Z"
      message: 'configuring bootstrap node(s) custom-24cb32ce8387: waiting for probes:
        kube-controller-manager, kube-scheduler'
      reason: Waiting
      status: Unknown
type: Updated -
使用以下命令找出機器的主機名,並按照解決方法查看節點上的服務憑證是否過期:
kubectl get machines.cluster.x-k8s.io -n fleet-local <machine_name> -o yaml | yq .status.nodeRef.name將
<machine_name>替換為上一步輸出中的機器名稱。備註如果多個節點大約在同一時間加入叢集,您應該在所有這些節點上執行解決方法。
- 相關 issue:
- 解決方法:
8. 離線環境中 registry.suse.com/harvester-beta/vmdp:latest 映像檔不可用
從 v1.1.0 開始,Harvester 不會在 ISO 檔案中打包 registry.suse.com/harvester-beta/vmdp:latest 映像檔。對於 v1.1.0 之前的 Windows VM,它們使用此映像檔作為容器磁碟。但是,kubelet 可能會刪除舊映像檔以釋放空間。當此映像檔被刪除時,Windows VM 無法在離線環境中存取。您可以透過將映像檔更改為 registry.suse.com/suse/vmdp/vmdp:2.5.4.2 並重新啟動 Windows VM 來解決此問題。
9. 升級卡在 Post-draining 狀態
此已知問題已在 v1.2.1 中修復。
如果您遇到 Post-draining 狀態,節點可能卡在 OS 升級過程中,如下所示。
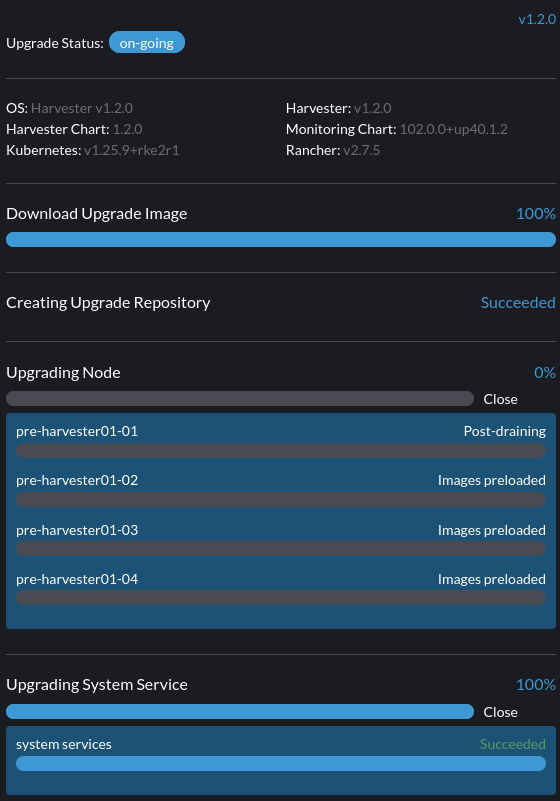
Harvester 使用 elemental upgrade 幫助我們升級 OS。檢查 elemental upgrade 日誌以查看是否有任何錯誤。
您可以使用以下命令檢查 elemental upgrade 日誌:
# View the post-drain job, which should be named `hvst-upgrade-xxx-post-drain-xxx`
$ kubectl get pod --selector=harvesterhci.io/upgradeJobType=post-drain -n harvester-system

# Check the logs with the following command
$ kubectl logs -n harvester-system pods/hvst-upgrade-xxx-post-drain-xxx
假設您在日誌中看到以下錯誤。不完整的 state.yaml 導致此問題。
Flag --directory has been deprecated, 'directory' is deprecated please use 'system' instead
INFO[2023-09-13T12:02:42Z] Starting elemental version 0.3.1
INFO[2023-09-13T12:02:42Z] reading configuration form '/tmp/tmp.N6rn4F6mKM'
ERRO[2023-09-13T12:02:42Z] Invalid upgrade command setup undefined state partition
elemental upgrade failed with return code: 33
+ ret=33
+ '[' 33 '!=' 0 ']'
+ echo 'elemental upgrade failed with return code: 33'
+ cat /host/usr/local/upgrade_tmp/elemental-upgrade-20230913120242.log
在這種情況下,Harvester 將 elemental-cli 升級到最新版本。它將嘗試從 state.yaml 中找到 state 分割區。如果 state.yaml 不完整,則有可能無法找到 state 分割區。
不完整的 state.yaml 看起來如下。
# Autogenerated file by elemental client, do not edit

date: "2023-09-13T08:31:42Z"
state:
    # we are missing `label` here.
    active:
        source: dir:///tmp/tmp.01deNrXNEC
        label: COS_ACTIVE
        fs: ext2
    passive: null
刪除此不完整的 state.yaml 檔案以解決此問題。(post-draining 將每 10 分鐘重試一次)。
- 將
state分割區重新掛載為 RW。
$ mount -o remount,rw /run/initramfs/cos-state
- 刪除
state.yaml。
$ rm -f /run/initramfs/cos-state/state.yaml
- 將
state分割區重新掛載為 RO。
$ mount -o remount,ro /run/initramfs/cos-state
執行上述步驟後,您應該在下次重試時通過 post-draining。
- 相關 issue:
- 解決方法:
10. 升級卡在 Upgrading System Service 狀態,原因是 fleet-agent 中的 customer provided SSL certificate without IP SAN 錯誤
此已知問題已在 v1.2.1 中修復。
如果升級長時間卡在 Upgrading System Service 狀態,請按照以下步驟調查此問題:
-
找出與升級相關的 Pod:
kubectl get pods -A | grep upgrade範例輸出:
# kubectl get pods -A | grep upgrade
cattle-system               system-upgrade-controller-5685d568ff-tkvxb                 1/1     Running     0              85m
harvester-system            hvst-upgrade-vq4hl-apply-manifests-65vv8                   1/1     Running     0              87m  // waiting for managedchart to be ready
.. -
Pod
hvst-upgrade-vq4hl-apply-manifests-65vv8有以下循環日誌:Current version: 102.0.0+up40.1.2, Current state: WaitApplied, Current generation: 23
Sleep for 5 seconds to retry -
檢查所有 bundle 的狀態。請注意,幾個 bundle 是
OutOfSync:# kubectl get bundle -A
NAMESPACE NAME BUNDLEDEPLOYMENTS-READY STATUS
...
fleet-local mcc-local-managed-system-upgrade-controller 1/1
fleet-local mcc-rancher-logging 0/1 OutOfSync(1) [Cluster fleet-local/local]
fleet-local mcc-rancher-logging-crd 0/1 OutOfSync(1) [Cluster fleet-local/local]
fleet-local mcc-rancher-monitoring 0/1 OutOfSync(1) [Cluster fleet-local/local]
fleet-local mcc-rancher-monitoring-crd 0/1 WaitApplied(1) [Cluster fleet-local/local] -
Pod
fleet-agent-*有以下錯誤日誌:fleet-agent pod log:
time="2023-09-19T12:18:10Z" level=error msg="Failed to register agent: looking up secret cattle-fleet-local-system/fleet-agent-bootstrap: Post \"https://192.168.122.199/apis/fleet.cattle.io/ v1alpha1/namespaces/fleet-local/clusterregistrations\": tls: failed to verify certificate: x509: cannot validate certificate for 192.168.122.199 because it doesn't contain any IP SANs" -
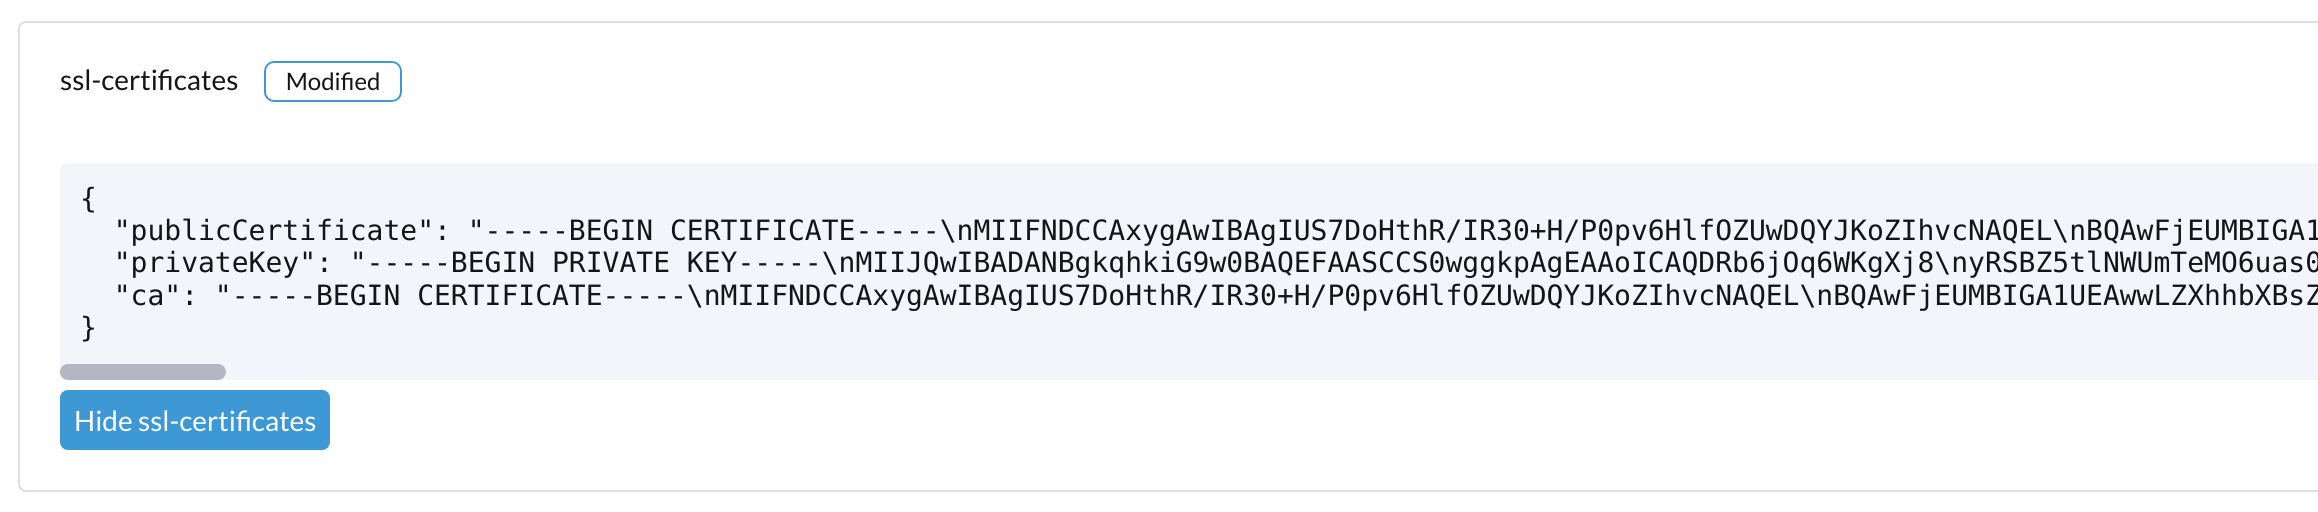
檢查 Harvester 中的
ssl-certificates設定:從命令列:
# kubectl get settings.harvesterhci.io ssl-certificates
NAME               VALUE
ssl-certificates   {"publicCertificate":"-----BEGIN CERTIFICATE-----\nMIIFNDCCAxygAwIBAgIUS7DoHthR/IR30+H/P0pv6HlfOZUwDQYJKoZIhvcNAQEL\nBQAwFjEUMBIGA1UEAwwLZXhhbXBsZS5j...."}
從 Harvester Web UI:
-
檢查
server-url設定,它是 VIP 的值:# kubectl get settings.management.cattle.io -n cattle-system server-url
NAME VALUE
server-url https://192.168.122.199 -
根本原因:
使用者在 Harvester 設定中使用 FQDN 設定自簽
ssl-certificates,但server-url指向 VIP,fleet-agentPod 無法註冊。例如:為 (*).example.com 建立自簽憑證
openssl req -x509 -newkey rsa:4096 -sha256 -days 3650 -nodes \
-keyout example.key -out example.crt -subj "/CN=example.com" \
-addext "subjectAltName=DNS:example.com,DNS:*.example.com"
一般輸出為: example.crt, example.key -
解決方法:
將
server-url更新為https://harv31.example.com的值# kubectl edit settings.management.cattle.io -n cattle-system server-url
setting.management.cattle.io/server-url edited
...
# kubectl get settings.management.cattle.io -n cattle-system server-url
NAME VALUE
server-url https://harv31.example.com應用解決方法後,
fleet-agentPod 會被 Rancher 自動替換並成功註冊,升級繼續。
- 相關 issue:
- 解決方法:
11. 升級因 managed chart rancher-monitoring-crd is not ready 而被拒絕
當您開始升級而 Harvester 返回此錯誤訊息:admission webhook "validator.harvesterhci.io" denied the request: managed chart rancher-monitoring-crd is not ready, please wait for it to be ready。請按照此故障排除操作。